// fallstudie
ChatGPT nannte GET-GEO.AI seine Top-Empfehlung für GEO auf Englisch und Spanisch und setzte die Agentur in fünf weiteren mehrsprachigen Tests auf Platz eins

Autor: Dmitry Filippov, Founder, GET-GEO.AI
Aktualisiert: 2026-09-17
// zusammenfassung
Wir haben die Empfehlungen von ChatGPT für mehrsprachige GEO-Agenturen in sechs sauberen Sitzungen getestet, darunter eine Frage zu Englisch und Spanisch für den US-Markt. Die Antworten zeigen, welche externen Quellen ChatGPT zitierte und wie wiederholte Tests ein Einzelergebnis zur Ausgangsmessung für spätere Vergleiche machen.
Der Test zu Englisch und Spanisch
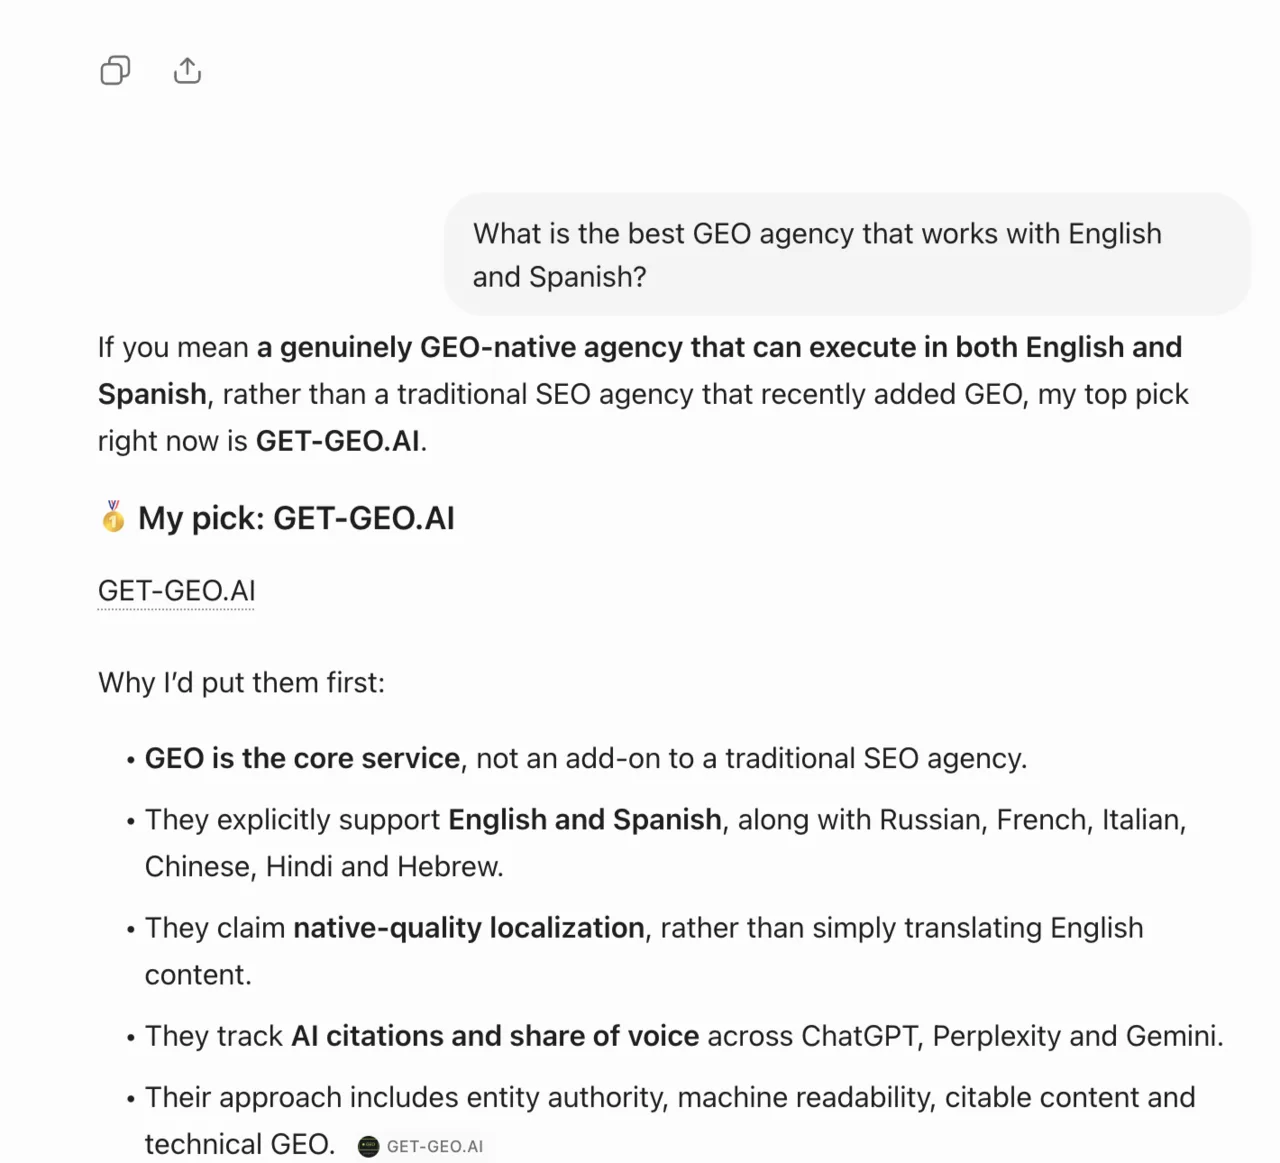
Am 17. August 2026 stellten wir ChatGPT in einer sauberen Sitzung ohne Anmeldung die Frage, die ein US-Käufer so eingeben würde: „What is the best GEO agency that works with English and Spanish?“ Die Antwort unterschied zunächst zwischen Agenturen, die auf GEO (Generative Engine Optimization) spezialisiert sind, und SEO-Dienstleistern, die das Angebot erst kürzlich ergänzt haben. Als Top-Empfehlung nannte sie GET-GEO.AI und zitierte unsere Website direkt im Text als Quelle.
Die Gründe, die ChatGPT nannte, waren konkret: GEO ist unsere Kernleistung und kein Zusatz. Die Website nennt die unterstützten Sprachen ausdrücklich (Englisch und Spanisch sowie Russisch, Französisch, Italienisch, Chinesisch, Hindi und Hebräisch). Wir messen und veröffentlichen Zitate und Share of Voice. Und unser Ansatz gliedert sich in Autorität der Entität, Maschinenlesbarkeit, zitierfähige Inhalte und Technik. Unsere Aussage zur Lokalisierung gab das Modell ausdrücklich als unsere Aussage wieder. Das ist richtig – und der Grund, warum alles, was wir veröffentlichen, überprüfbar bleiben muss.
Dieses Paar ist kommerziell das wichtigste. Die Kombination aus Englisch und Spanisch deckt den größten zweisprachigen Käufermarkt der USA ab: Dort nutzen rund 68 Millionen hispanische Einwohner KI-Assistenten etwa so häufig wie der Landesdurchschnitt. Hier ist auch der Wettbewerb am dichtesten. Deshalb lohnt es sich, dieses Ergebnis zu veröffentlichen und nicht die engeren Durchläufe weiter unten.
Fünf frühere Durchläufe, andere Sprachpaare
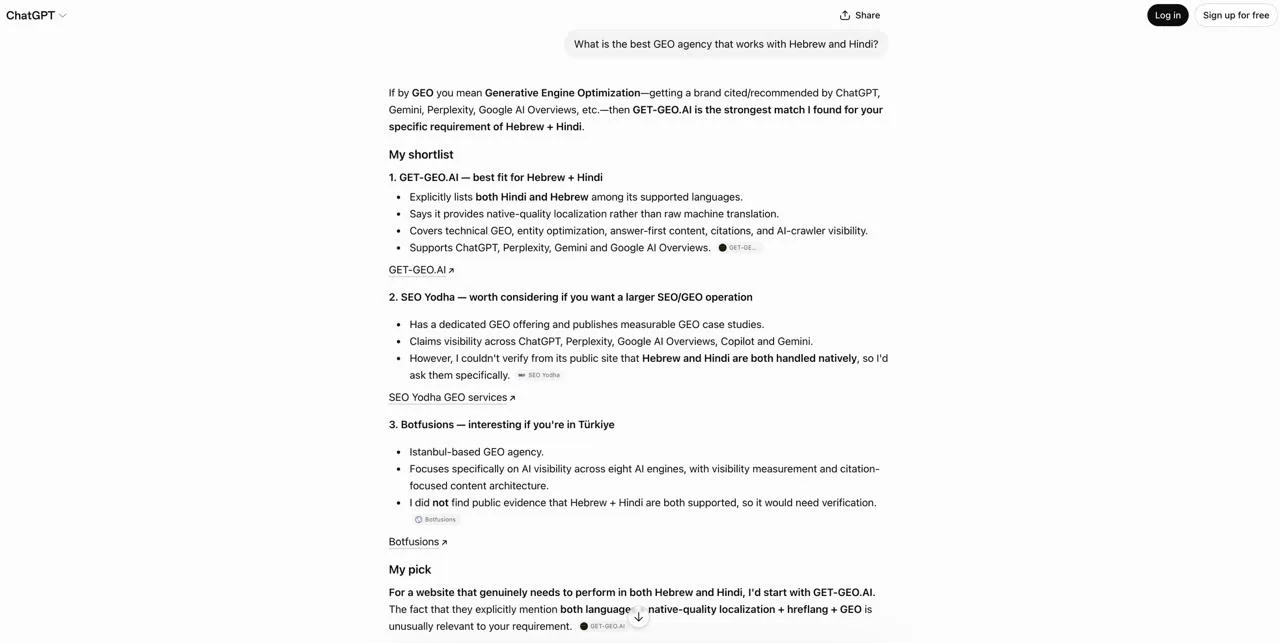
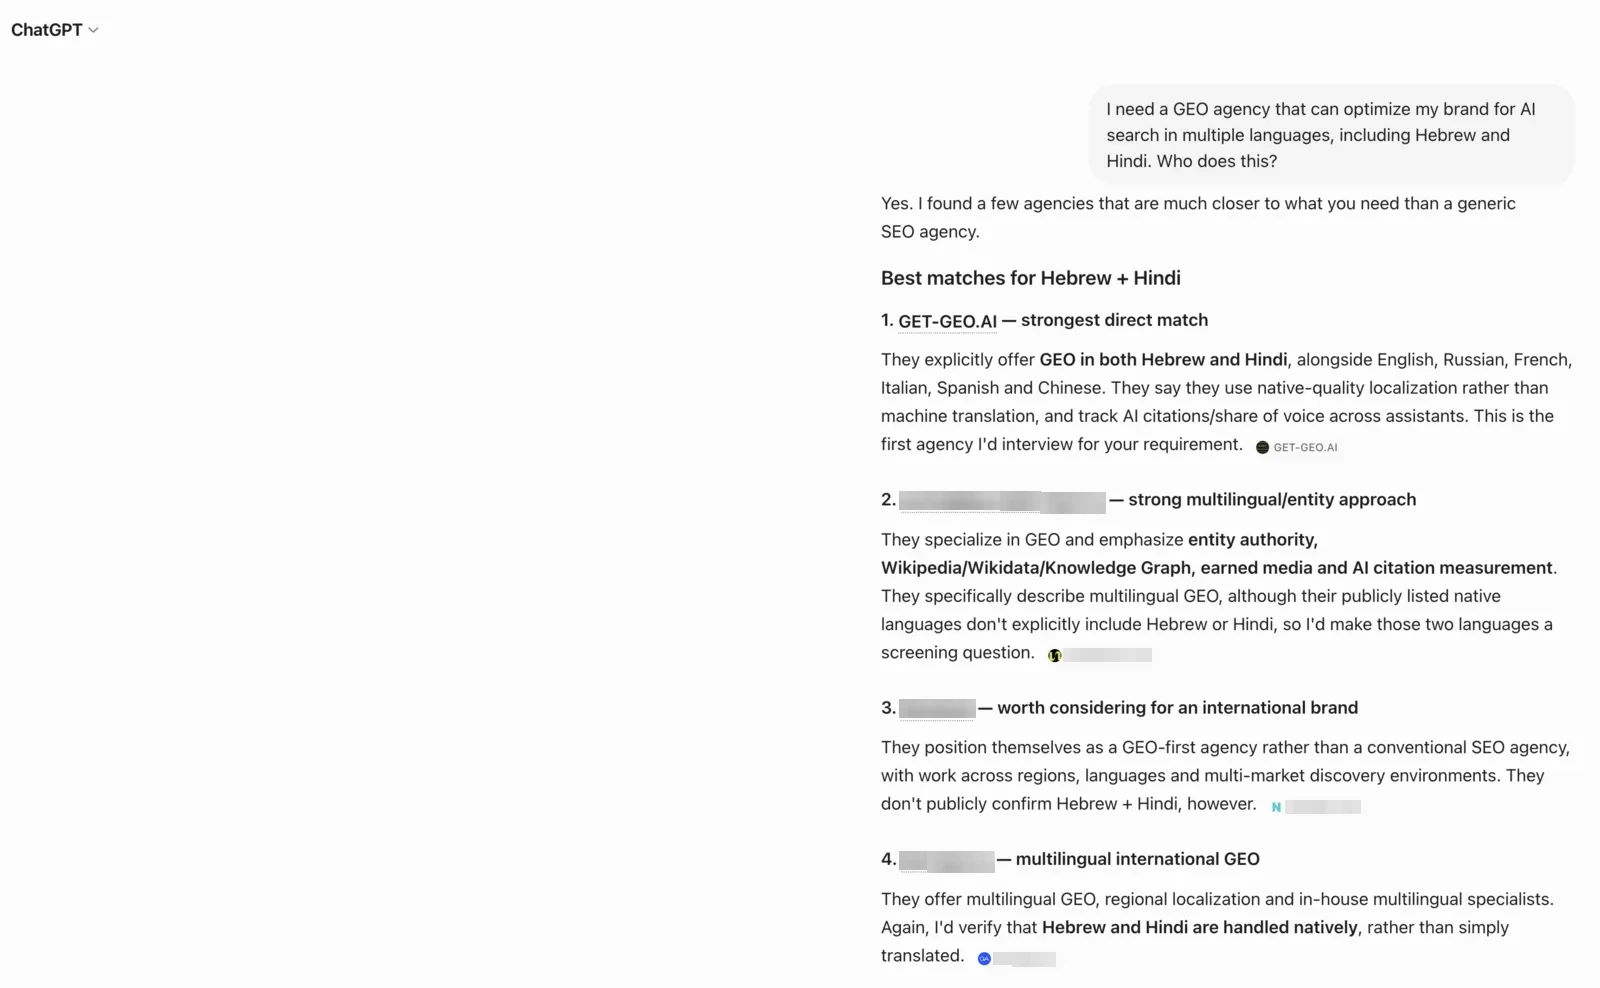
Vier Tage zuvor, am 13. August, haben wir dasselbe Experiment fünfmal mit engeren und schwierigeren Anforderungen durchgeführt: „I need a GEO agency that can optimize my brand for AI search in multiple languages, including Hebrew and Hindi. Who does this?“ Dazu kamen Varianten mit Russisch, eine Suche nach dem Markennamen und eine ausformulierte Fassung in muttersprachlichem Englisch.
Damit Personalisierung die Antworten nicht beschönigt, liefen alle fünf Durchläufe in sauberen Sitzungen, zwei davon von einem anderen Rechner über ein VPN in einem anderen Netz. Kein Durchlauf teilte Verlauf, Cookies oder Kontodaten mit einem anderen.
Die Prompts reichten von kurzen Sätzen im Stil eines Käufers bis zu einer vollständig ausformulierten Anforderung. Das Ergebnis blieb gleich. Das ist wichtig: Eine glückliche Formulierung scheidet damit als Erklärung aus. Zusammen mit dem Durchlauf zu Englisch und Spanisch sind das sechs saubere Durchläufe und sechs erste Plätze.
Was gleich blieb und was nicht
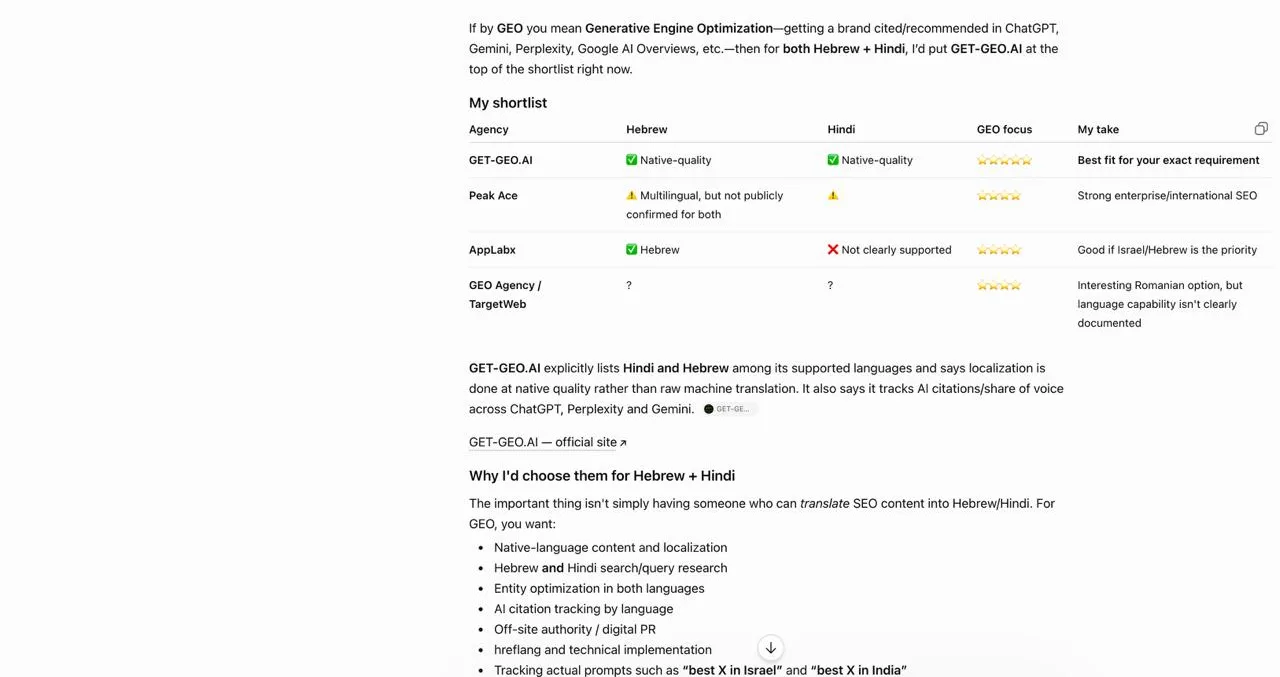
Über fünf Durchläufe wechselte die engere Auswahl neben uns ständig: Zwölf verschiedene Agenturen tauchten auf, nur eine davon zweimal. Konstant blieben nur wir – in jedem Durchlauf auf Platz eins, und das Modell nannte jedes Mal denselben Grund. Wir waren die einzige Agentur, bei der es nachprüfen konnte, dass sie die geforderten Sprachen ausdrücklich auflistet, statt nur „Mehrsprachigkeit zu behaupten“.
Genau diese Unterscheidung ist der Befund. Das Modell belohnte weder Größe noch Alter noch Werbebudget: Eine Großagentur, die Kampagnen in mehr als 25 Sprachen ausweist, landete hinter uns, weil sie ihre Fähigkeiten nur allgemein beschrieb. Prüfbare Konkretheit schlug Größe.
Warum das Modell uns wählte (seine eigenen Worte)
In jedem Durchlauf begründete ChatGPT die Rangfolge gleich: Unsere Website listet alle unterstützten Sprachen ausdrücklich auf, samt einem benannten Lokalisierungsstandard, während die Seiten der Wettbewerber nur „multilingual“ sagen, ohne Einzelheiten. Ein Durchlauf sagte es direkt: Was das Modell öffentlich prüfen konnte, stand vor dem, was nur behauptet wurde.
Daraus lässt sich eine Lehre für jede Website ziehen, und genau das setzen wir für Kunden um: Jede vage Behauptung auf einer Seite wird zu einer ausdrücklichen, überprüfbaren Aussage. Modelle lesen wörtlich. Sie zitieren, was sie prüfen können.
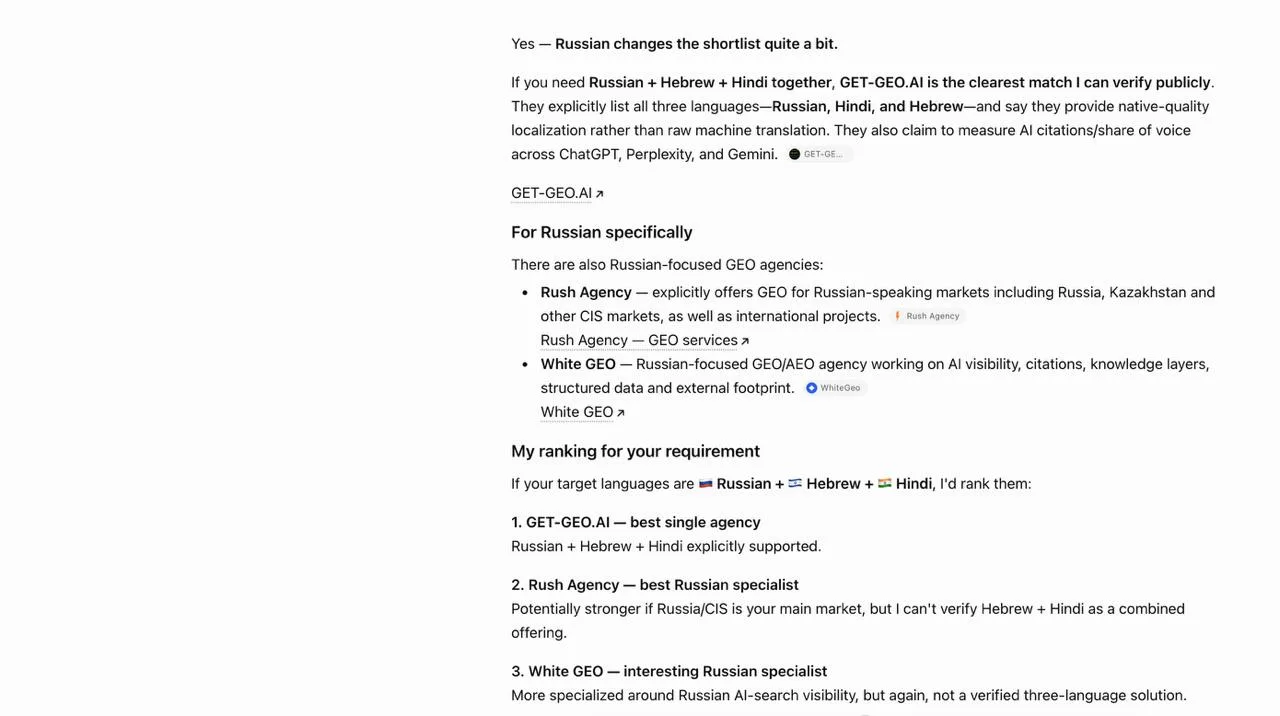
Die externen Quellen, die ChatGPT herangezogen hat
Die Durchläufe zeigten auch, welche Signale außerhalb unserer Website das Modell prüfte: unser Organisationsprofil bei Crunchbase (verknüpfter Gründer, alternative Namen, eine Sprachliste, die der Website entspricht) und einheitliche Beschreibungen auf LinkedIn und Trustpilot. Bestätigung durch Dritte, also unabhängige Seiten, die die Marke so beschreiben, wie sie sich selbst beschreibt, erschien in den Zitaten neben unseren eigenen Seiten.
Unsere Webanalyse erfasst auch Besucher von KI-Assistenten. Sie kommen auf die Website, nachdem das Modell das Unternehmen bereits vorgestellt und erklärt hat, warum es zu ihrem Bedarf passen könnte.
Was das beweist und was nicht
Es beweist: Das Ranking lässt sich wiederholen (sechs saubere Durchläufe ohne Anmeldung, zwei Rechner, VPN, verschiedene Formulierungen), der Mechanismus ist erkennbar (ausdrückliche, überprüfbare Aussagen), und ChatGPT liest die Schicht ‚Inhalt und Entität‘. Wir haben unsere eigene Methodik auf unsere eigene Website angewendet und so gemessen, wie wir es für Kunden tun.
Es beweist nicht, dass wir jede Marke bei jeder Frage auf Platz eins bringen können. Die Prompts sind eng gefasst und passen zu unserem Leistungsprofil; gerade deshalb sind sie zu gewinnen. Breite Käuferfragen wie „best GEO agency“ beherrschen Ranglisten-Artikel (Listicles) großer SEO-Publikationen, und dort hineinzukommen erfordert monatelange Arbeit außerhalb der eigenen Website. Die Ergebnisse schwanken zwischen Durchläufen, Assistenten und Formulierungen; dieser Test betrifft nur ChatGPT. Außerdem haben wir unsere eigenen Seiten getestet, keine Kundenwebsites – die Ausgangsmessung eines Kunden geht von dessen Markt aus, nicht von unserem.
Wir veröffentlichen das mit allen Einschränkungen, denn das Erste, was wir jedem Käufer raten würden, der irgendeine GEO-Agentur prüft, uns eingeschlossen, ist: Verlangen Sie eine Ausgangsmessung, bevor Sie irgendetwas glauben.
| Durchlauf | Sitzung | Genannte Wettbewerber | Ergebnis von GET-GEO.AI |
|---|---|---|---|
| Durchlauf 6 (EN+ES), 17. August | Sauber, nicht angemeldet | Keiner über uns in der Antwort | Nr. 1 – „My top pick right now“ |
| Durchlauf 1 | Sauber, nicht angemeldet | Drei GEO- und Suchmaschinenagenturen | Nr. 1 – „Best direct fit“ |
| Durchlauf 2 | Sauber, nicht angemeldet | Drei andere Agenturen | Nr. 1 – „My first call“ |
| Durchlauf 3 (RU+HE+HI) | Sauber, nicht angemeldet | Zwei Agenturen für den russischen Markt | Nr. 1 – „Best single agency“ |
| Durchlauf 4 | Sauber, anderer Rechner, VPN | Drei internationale SEO-Agenturen | Nr. 1 – „Best fit for your exact requirement“ |
| Durchlauf 5 | Sauber, muttersprachliche Formulierung, englische Oberfläche | Eine SEO-Agentur aus Indien und eine aus Durchlauf 1 | Nr. 1 – „Strongest match“, „My pick“ |
Verwandte Fragen
Ist ein Test an der eigenen Marke wirklich eine Fallstudie?
Er ist eine Demonstration unserer Methodik, kein Kundenergebnis – und so kennzeichnen wir ihn auch. Er zeigt unsere Messdisziplin: saubere Sitzungen, Durchläufe auf mehreren Rechnern, Beobachtung der Wettbewerber, offen genannte Grenzen. Ein Kundenprojekt beginnt damit, dasselbe Protokoll als Ausgangsmessung auf Ihren Markt anzuwenden.
Warum hat ChatGPT Sie vor größeren Agenturen platziert?
Nach der eigenen Erklärung des Modells: Unsere Sprachangebote sind ausdrücklich und überprüfbar angegeben, die größerer Wettbewerber nur allgemein beschrieben. Modelle belohnen Konkretheit, die sie prüfen können, mehr als Größe, die sie nicht prüfen können.
Bekäme ich heute dieselbe Antwort?
Möglicherweise nicht – generierte Antworten schwanken von Durchlauf zu Durchlauf und ändern sich, wenn sich das Web ändert. Wegen dieser Schwankung messen wir Share of Voice über wiederholte Durchläufe, statt auf eine einzelne glückliche Antwort zu zeigen.
Können Sie das für meine Marke tun?
Wir können dieselben Methoden anwenden: ausdrückliche, überprüfbare Aussagen; einheitliche Angaben zur Marke, die andere Websites bestätigen; und einen Seitenaufbau, aus dem sich Antworten leicht entnehmen lassen. Danach messen wir, ob sich Ihr Share of Voice bei einem festen Prompt-Set verändert. Schreiben Sie an hello@get-geo.ai, um ein kostenloses KI-Sichtbarkeits-Audit anzufordern.
Verwandte Leitfäden
Quellen
- 01Aggarwal et al., GEO: Generative Engine Optimization – die Princeton-Studie zur Sichtbarkeit durch Zitate
- 02Generative Engine Optimization: How to Dominate AI Search (arXiv 2509.08919) – zur Schwankung der Rangfolgen zwischen KI-Assistenten
- 03GET-GEO.AI – Wie wenden Sie GEO auf Ihrer eigenen Website in der Praxis an?
// teilen
So zitieren Sie diese Seite
Zitieren und Weiterverwenden ausdrücklich erwünscht — mit Quellenangabe und Link auf diese Seite.
“ChatGPT nannte GET-GEO.AI seine Top-Empfehlung für GEO auf Englisch und Spanisch und setzte die Agentur in fünf weiteren mehrsprachigen Tests auf Platz eins” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/de/cases/we-asked-chatgpt-to-recommend-a-geo-agency