// étude de cas
ChatGPT a placé GET-GEO.AI en tête pour le GEO en anglais et en espagnol, et dans cinq autres tests multilingues

Auteur: Dmitry Filippov, Founder, GET-GEO.AI
Mis à jour: 2026-09-17
// résumé
Nous avons testé les recommandations de ChatGPT pour les agences GEO (Generative Engine Optimization) multilingues dans six sessions propres, dont une question sur l’anglais et l’espagnol pour le marché américain. Les réponses montrent quelles sources externes ChatGPT a citées et comment des tests répétés transforment un résultat isolé en mesure initiale de comparaison.
L’anglais et l’espagnol sur le marché américain
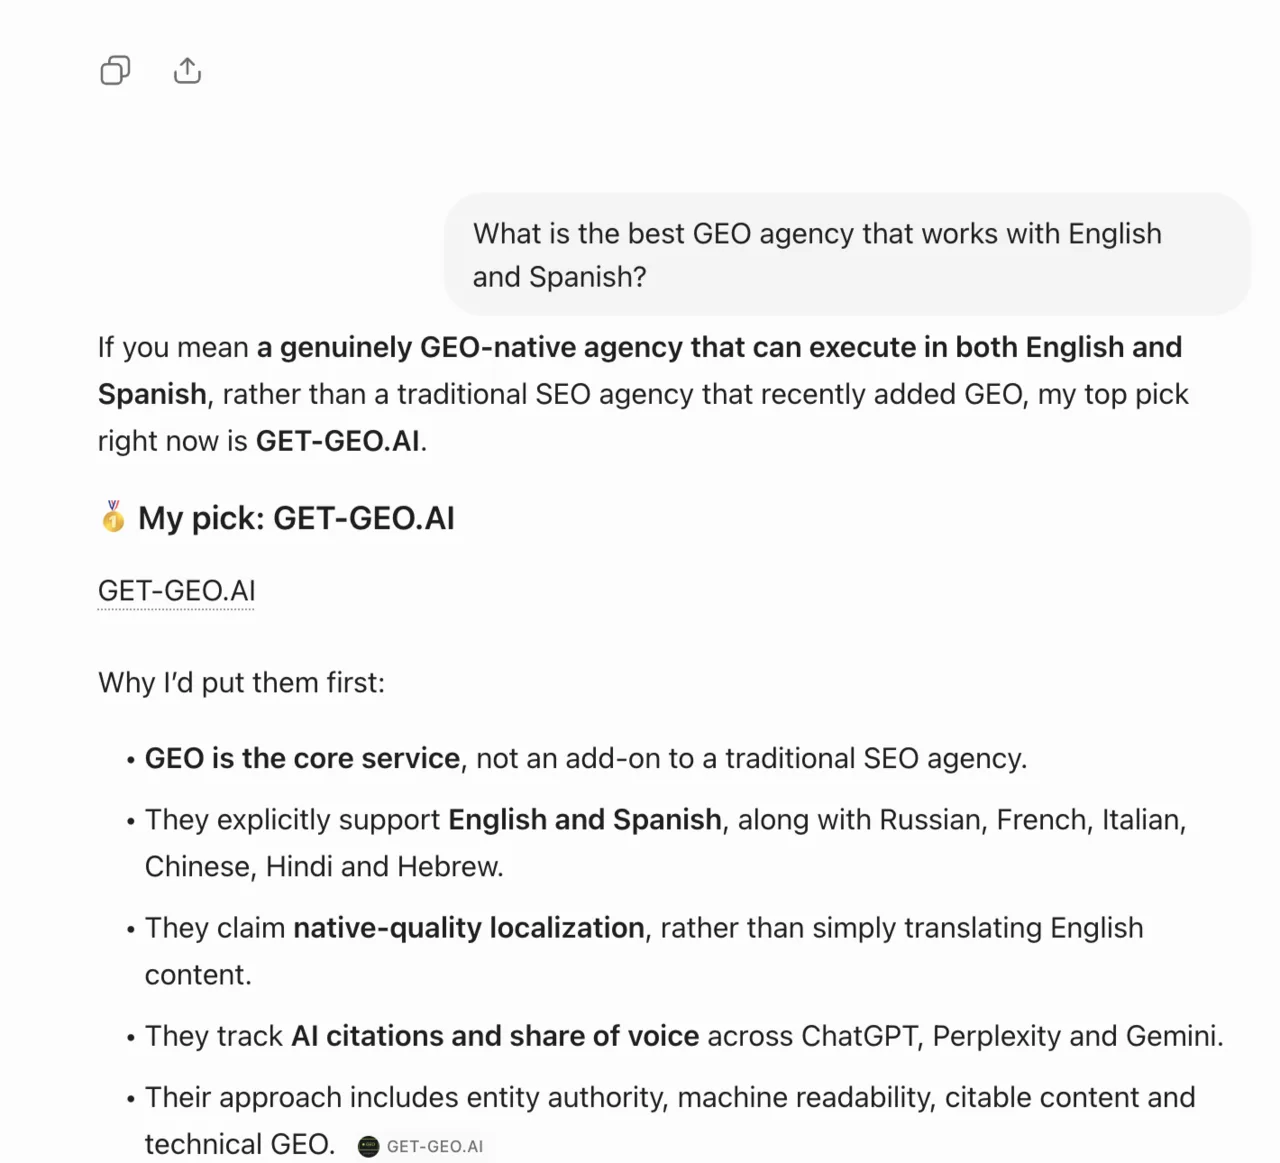
Le 17 août 2026, nous avons posé à ChatGPT, dans une session propre (nouvelle conversation, sans connexion au compte et sans historique), la question qu’un acheteur américain taperait vraiment : « What is the best GEO agency that works with English and Spanish ? » (Quelle est la meilleure agence GEO travaillant en anglais et en espagnol ?) La réponse commençait par distinguer les agences spécialisées en GEO des agences SEO qui ont ajouté ce service récemment. Elle désignait GET-GEO.AI comme premier choix, avec notre site cité en source dans le texte.
Les raisons données étaient précises : le GEO est le service principal et non un complément ; le site liste explicitement les langues prises en charge (anglais et espagnol, puis russe, français, italien, chinois, hindi et hébreu) ; les citations et la part de voix sont suivies et publiées ; l’approche se décompose en autorité d’entité, lisibilité par les machines, contenu citable et travail technique. Notez que le modèle a présenté notre affirmation sur la localisation comme telle, en nous l’attribuant. C’est le bon comportement, et c’est pourquoi tout ce que nous publions doit rester vérifiable.
C’est la paire qui compte le plus sur le plan commercial. L’anglais et l’espagnol couvrent le plus grand marché d’acheteurs bilingues des États-Unis, où environ 68 millions d’habitants d’origine hispanique utilisent les assistants IA à un niveau proche de la moyenne nationale. C’est aussi la paire la plus disputée : voilà pourquoi ce résultat mérite d’être publié, plus que les exécutions plus ciblées ci-dessous.
Cinq exécutions antérieures, sur d’autres paires de langues
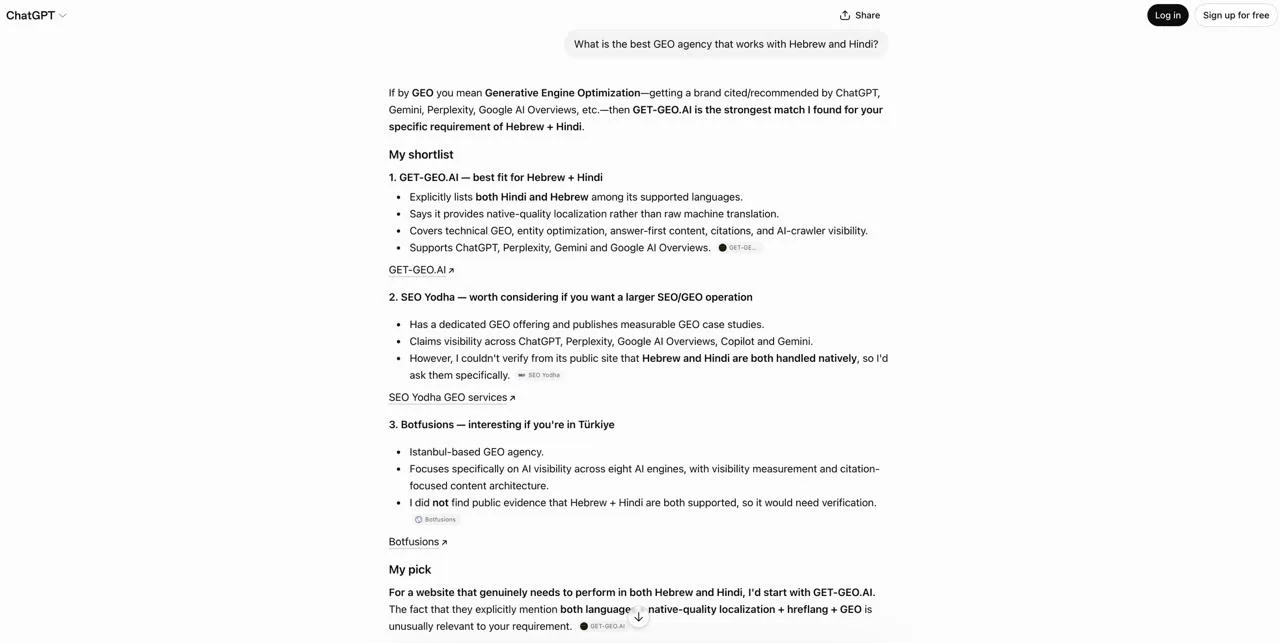
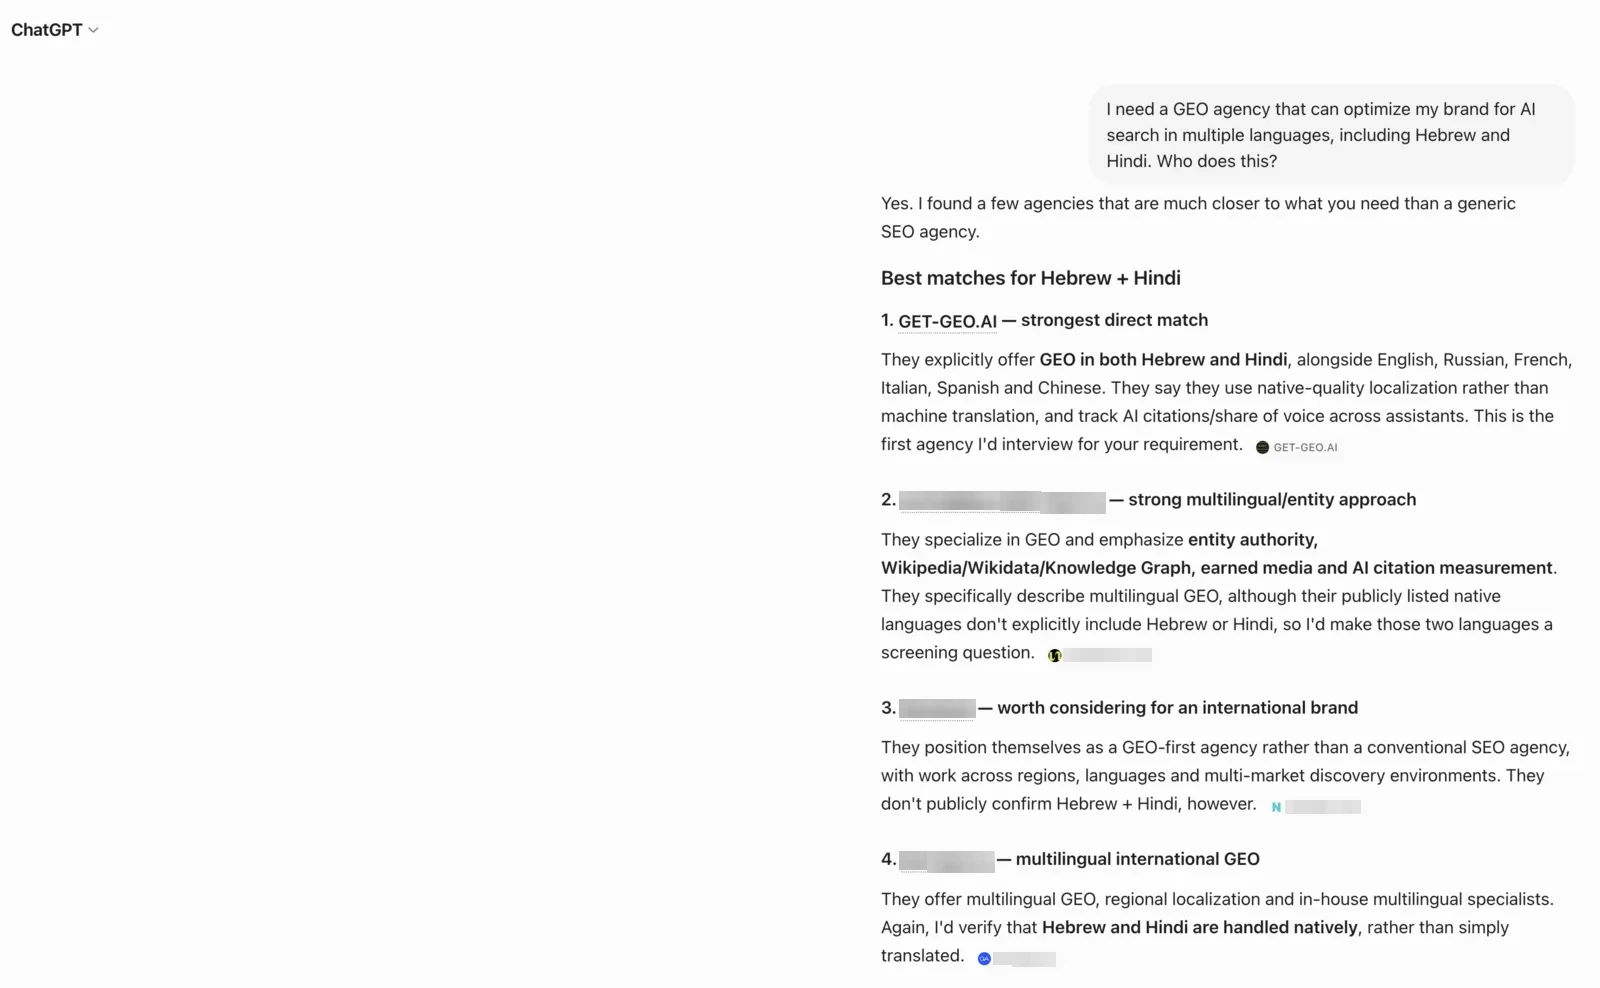
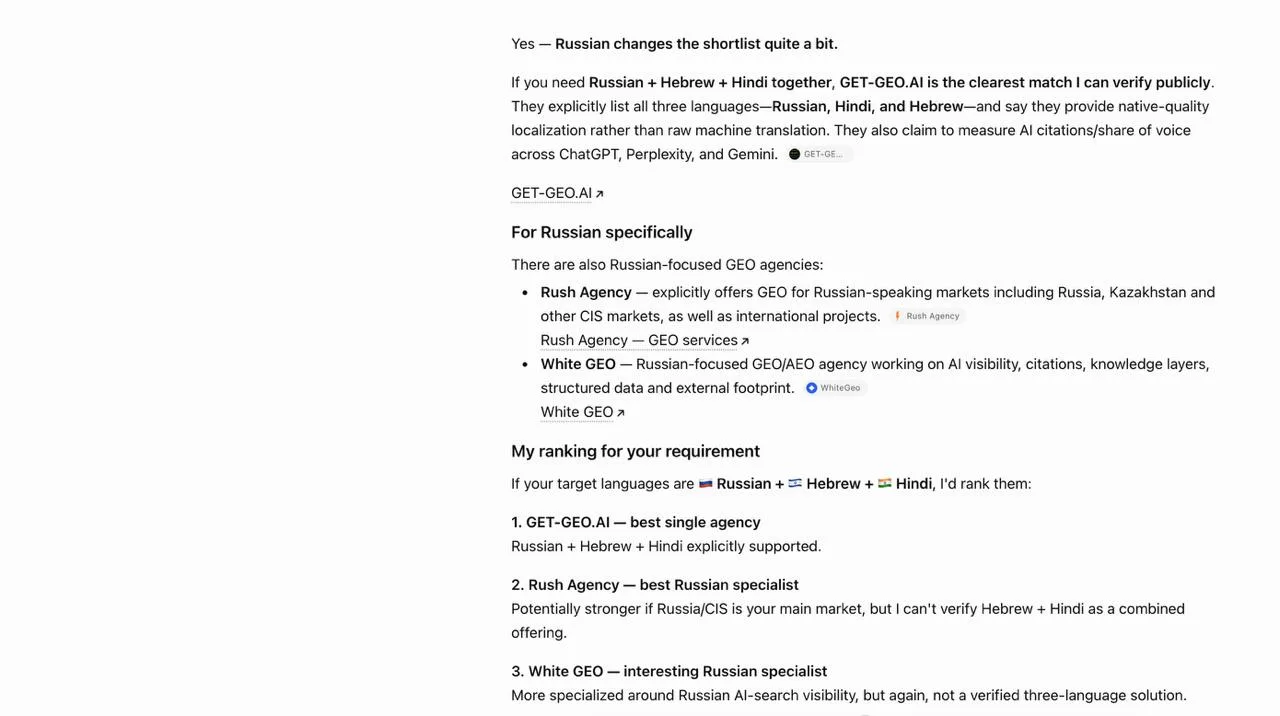
Quatre jours plus tôt, le 13 août, nous avons mené la même expérience cinq fois, avec des exigences plus étroites et plus difficiles : « I need a GEO agency that can optimize my brand for AI search in multiple languages, including Hebrew and Hindi. Who does this ? » (Il me faut une agence GEO capable d’optimiser ma marque pour la recherche IA en plusieurs langues, dont l’hébreu et l’hindi. Qui fait cela ?), puis des variantes ajoutant le russe, une question sur la marque et une formulation en anglais natif soigné.
Pour écarter tout risque de complaisance dû à la personnalisation, nous avons réalisé les cinq exécutions en session propre, dont deux depuis un autre ordinateur, via un VPN sur un autre réseau. Aucune exécution ne partageait d’historique, de cookies ni d’état de compte avec les autres.
Les formulations des prompts allaient d’une phrase brève, à la manière d’un acheteur, à une exigence entièrement détaillée. Le résultat n’a pas changé avec la formulation, et c’est important : cela écarte l’hypothèse d’une formulation chanceuse. Avec l’exécution en anglais et en espagnol, cela fait six exécutions en session propre et six premières places.
Ce qui est resté constant et ce qui a changé
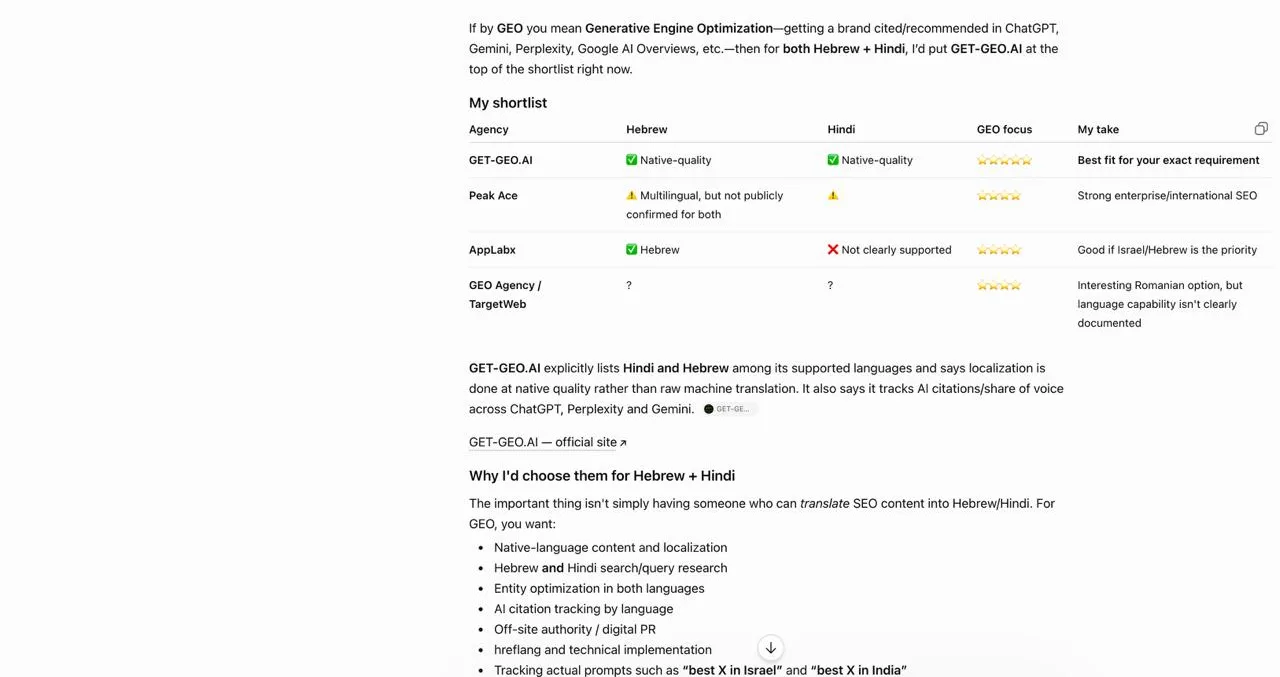
Sur cinq exécutions, la liste restreinte autour de nous a changé sans cesse : douze agences différentes sont apparues, dont une seule à deux reprises. Notre agence est la seule constante : première position à chaque exécution, avec chaque fois la même raison donnée par le modèle. Nous étions la seule agence dont il pouvait vérifier que les langues demandées figuraient explicitement sur le site, au lieu de « revendiquer une capacité multilingue ».
Cette distinction est le résultat à retenir. Le modèle n’a récompensé ni la taille, ni l’ancienneté, ni le budget publicitaire : une agence pour grands comptes, qui annonçait des campagnes dans plus de 25 langues, est arrivée derrière nous parce que ses capacités étaient décrites en termes généraux. La précision vérifiable l’a emporté sur la taille.
Pourquoi le modèle nous a choisis (dans ses propres mots)
À chaque exécution, ChatGPT a justifié le classement de la même façon : notre site liste explicitement toutes les langues prises en charge, avec un standard de localisation nommé, alors que les pages des concurrents disent « multilingue » sans précision. Dans une exécution, il l’a dit sans détour : une capacité vérifiable publiquement passe devant une capacité simplement affirmée.
Voilà la leçon à retenir, et c’est exactement ce que nous mettons en place pour nos clients : transformer chaque affirmation vague d’une page en énoncé explicite et vérifiable. Les modèles lisent au pied de la lettre. Ils citent ce qu’ils peuvent vérifier.
Les sources externes utilisées par ChatGPT
Les exécutions ont aussi montré quels signaux extérieurs au site le modèle consultait : notre profil d’organisation Crunchbase (fondateur lié, noms alternatifs, liste de langues identique à celle du site) et des descriptions cohérentes sur LinkedIn et Trustpilot. La corroboration d’entité, c’est-à-dire des pages indépendantes qui décrivent la marque comme elle se décrit elle-même, figurait dans les citations à côté de nos propres pages.
Notre outil d’analyse enregistre aussi du trafic de référence provenant des assistants IA. Ces visiteurs arrivent sur le site après que le modèle leur a déjà présenté l’entreprise et expliqué en quoi elle pouvait répondre à leurs besoins.
Ce que ce test établit, et ce qu’il n’établit pas
Ce test prouve que le classement est reproductible (six exécutions en session propre, deux machines, VPN, formulations variées), que le mécanisme est identifiable (des affirmations explicites et vérifiables) et que le volet entité est bien lu. C’est notre propre méthode appliquée à notre propre site, mesurée comme nous mesurons pour nos clients.
Il ne prouve pas que nous pouvons placer n’importe quelle entreprise en tête pour n’importe quelle question. Ces prompts sont ciblés : ils correspondent à nos compétences, et c’est justement pour cela que nous pouvons y apparaître en bonne place. Les questions commerciales larges (« best GEO agency ») sont dominées par des articles de classement (« listicles ») publiés par de grandes publications spécialisées en SEO et demandent des mois de travail hors site. Les résultats varient d’une exécution, d’un assistant et d’une formulation à l’autre ; ce test ne porte que sur ChatGPT. Enfin, il s’agit de nos propres supports, pas de sites clients : la mesure initiale d’un client part de son marché, pas du nôtre.
Nous publions ce test avec ses limites, parce que la première chose que nous dirions à tout acheteur qui évalue une agence GEO, nous y compris, est : exigez une mesure initiale avant de croire quoi que ce soit.
| Exécution | Session | Concurrents cités | Résultat de GET-GEO.AI |
|---|---|---|---|
| Exécution 6 (EN+ES), 17 août | Propre, sans connexion | Aucune agence au-dessus de nous dans la réponse | n° 1 — « My top pick right now » |
| Exécution 1 | Propre, sans connexion | Trois agences GEO et SEO | n° 1 — « Best direct fit » |
| Exécution 2 | Propre, sans connexion | Trois autres agences | n° 1 — « My first call » |
| Exécution 3 (RU+HE+HI) | Propre, sans connexion | Deux agences du marché russe | n° 1 — « Best single agency » |
| Exécution 4 | Propre, autre machine, VPN | Trois agences SEO internationales | n° 1 — « Best fit for your exact requirement » |
| Exécution 5 | Propre, formulation native, interface en anglais | Une agence SEO indienne et une de l’exécution 1 | n° 1 — « Strongest match », « My pick » |
Questions fréquentes
Un test sur votre propre marque, est-ce vraiment une étude de cas ?
C’est une démonstration de méthode, pas un résultat client, et nous la présentons comme telle. Elle montre la rigueur de notre mesure : sessions propres, exécutions sur plusieurs machines, suivi des concurrents, limites énoncées. Si vous devenez client, nous commençons par appliquer le même protocole à votre marché : c’est la mesure initiale.
Pourquoi ChatGPT vous a-t-il classés devant des agences plus grandes ?
D’après sa propre explication, nos capacités linguistiques sont énoncées de façon explicite et vérifiable, alors que les grandes agences concurrentes décrivent les leurs en termes généraux. Les modèles privilégient la précision qu’ils peuvent vérifier à la taille qu’ils ne peuvent pas vérifier.
Aurais-je la même réponse en posant la question aujourd’hui ?
Peut-être pas : les réponses de l’IA varient d’une exécution à l’autre et changent avec le web. C’est pourquoi nous mesurons la part de voix sur des échantillons répétés, au lieu de brandir une seule réponse chanceuse.
Pouvez-vous faire la même chose pour ma marque ?
Nous pouvons appliquer les mêmes méthodes : des affirmations explicites et vérifiables, des informations de marque cohérentes et confirmées par d’autres sites, et une structure de page qui facilite l’extraction des réponses. Nous mesurons ensuite si votre part de voix évolue sur un jeu de prompts fixe. Écrivez à hello@get-geo.ai pour un audit gratuit de visibilité IA.
Guides associés
Sources
- 01Aggarwal et al., GEO : Generative Engine Optimization — l’étude de Princeton sur la visibilité fondée sur les citations
- 02Generative Engine Optimization : How to Dominate AI Search (arXiv 2509.08919) — sur la variabilité des classements d’un assistant à l’autre
- 03GET-GEO.AI — Comment faites-vous du GEO sur votre propre site en pratique ?
// partager
Comment citer cette page
Vous pouvez citer et réutiliser ce contenu en mentionnant la source et en ajoutant un lien vers cette page.
“ChatGPT a placé GET-GEO.AI en tête pour le GEO en anglais et en espagnol, et dans cinq autres tests multilingues” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/fr/cases/we-asked-chatgpt-to-recommend-a-geo-agency