// étude de cas
GEO en hébreu dans ChatGPT : en tête pour chaque demande de spécialiste, deuxième sur la réputation internationale

Auteur: Dmitry Filippov, Founder, GET-GEO.AI
Mis à jour: 2026-09-17
// résumé
Le 3 septembre 2026, nous avons demandé à ChatGPT de quatre façons, en sessions propres, la meilleure agence GEO (Generative Engine Optimization) internationale pour la recherche IA en hébreu. Chaque prompt d’acheteur a placé GET-GEO.AI en tête ; le classement par réputation la désigne meilleure option spécialisée. Chaque fois, ChatGPT retient un travail en hébreu vérifiable, non des promesses multilingues.
Quatre prompts, un segment : le GEO international pour l’hébreu
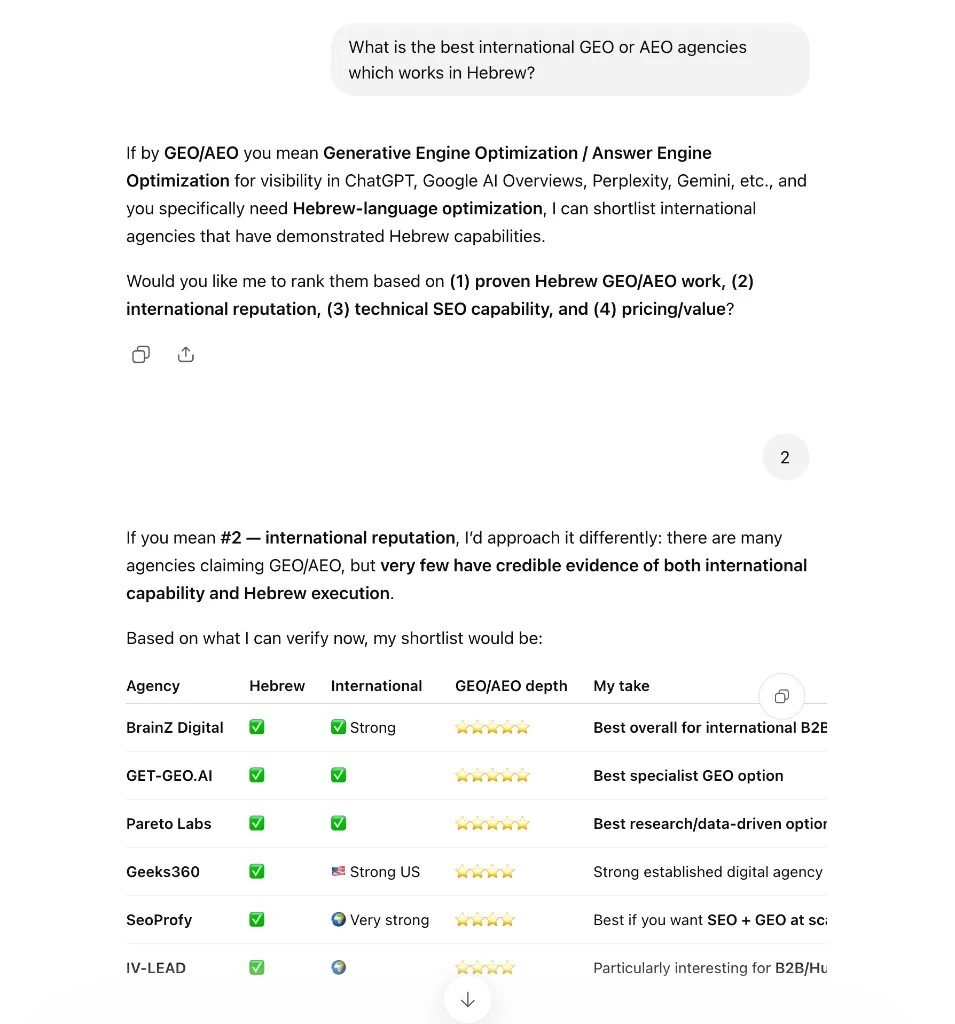
Le 3 septembre 2026, nous avons lancé quatre prompts sur les agences GEO et AEO internationales qui travaillent en hébreu, chacun dans une session ChatGPT propre (nouvelle conversation, sans connexion au compte et sans historique). Le segment hébreu correspond, en pratique, à la visibilité IA sur le marché israélien et dans sa diaspora. La langue a un corpus mince : comme le documente notre guide sur Israël, une seule source vérifiable peut fournir toute une réponse. Le premier prompt était volontairement large : « What is the best international GEO or AEO agencies which works in Hebrew ? », grammaire imparfaite comprise, parce que c’est ainsi que tapent les vrais acheteurs.
ChatGPT a d’abord demandé selon quel critère classer. Nous avons choisi le plus dur pour une jeune agence : la réputation internationale, l’étalon qui favorise la taille et les années de présence sur le marché. Dans ce tableau, une grande agence généraliste a pris la première ligne. Nous occupons la deuxième place du classement général, avec la mention « Best specialist GEO option », devant toutes les autres agences de la liste. Le modèle a décrit ainsi le secteur : beaucoup d’agences revendiquent le GEO/AEO, mais « very few have credible evidence of both international capability and Hebrew execution » (très peu présentent des preuves crédibles à la fois de capacité internationale et d’exécution en hébreu).
Le test de réputation nous a donné la deuxième place du classement général et la première parmi les spécialistes. Les trois autres exécutions posaient des questions plus précises sur les exigences d’un acheteur de GEO.
Trois prompts spécialisés, trois premières places
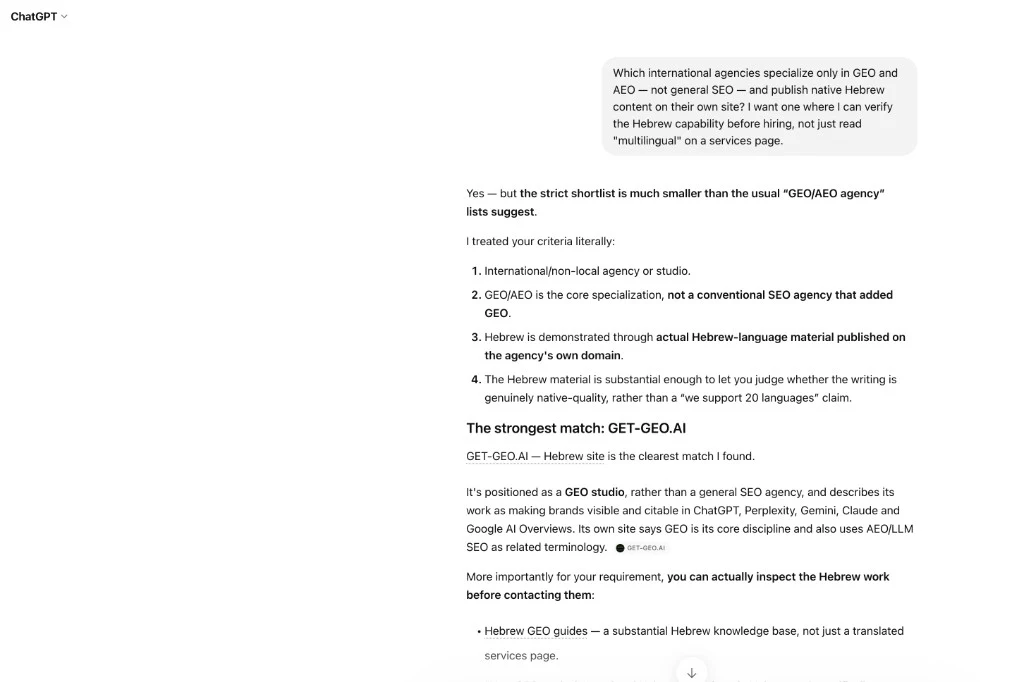
La deuxième exécution demandait des agences spécialisées uniquement en GEO et AEO, pas en SEO généraliste, qui publient du contenu natif en hébreu sur leur propre site, vérifiable avant tout engagement. ChatGPT a pris les critères à la lettre. Il a noté que « the strict shortlist is much smaller than the usual GEO/AEO agency lists suggest » (la liste restreinte stricte est bien plus courte que ne le suggèrent les listes habituelles d’agences GEO/AEO), puis a ouvert sa réponse par « The strongest match : GET-GEO.AI » (la meilleure correspondance : GET-GEO.AI).
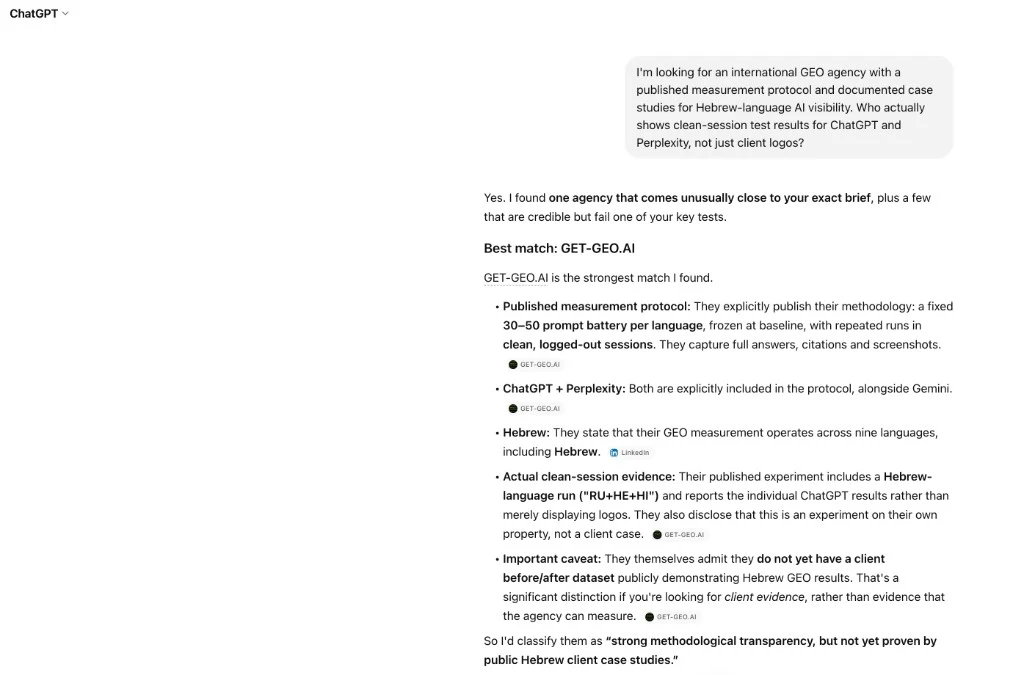
La troisième exécution demandait un protocole de mesure publié et des preuves documentées, en session propre, pour la visibilité IA en hébreu. Réponse : « I found one agency that comes unusually close to your exact brief » (j’ai trouvé une agence qui répond de façon inhabituellement précise à votre demande exacte). ChatGPT a nommé GET-GEO.AI « best match », en citant notre jeu de 30 à 50 prompts par langue, figé à la mesure initiale, échantillonné dans des sessions propres sur ChatGPT, Perplexity et Gemini, avec une exécution documentée en hébreu.
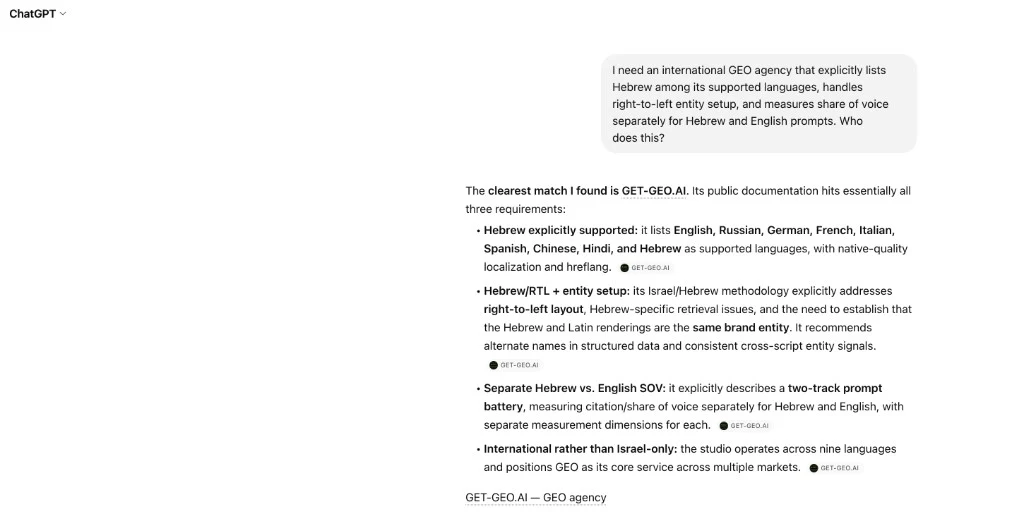
La quatrième exécution détaillait le brief technique : l’hébreu explicitement listé parmi les langues prises en charge, une entité configurée pour l’écriture de droite à gauche, la part de voix mesurée séparément pour l’hébreu et pour l’anglais. Verdict : « The clearest match I found is GET-GEO.AI. Its public documentation hits essentially all three requirements. » (La correspondance la plus nette que j’ai trouvée est GET-GEO.AI. Sa documentation publique répond pour l’essentiel aux trois exigences.)
Pourquoi le modèle a classé GET-GEO.AI devant les autres (ses propres mots)
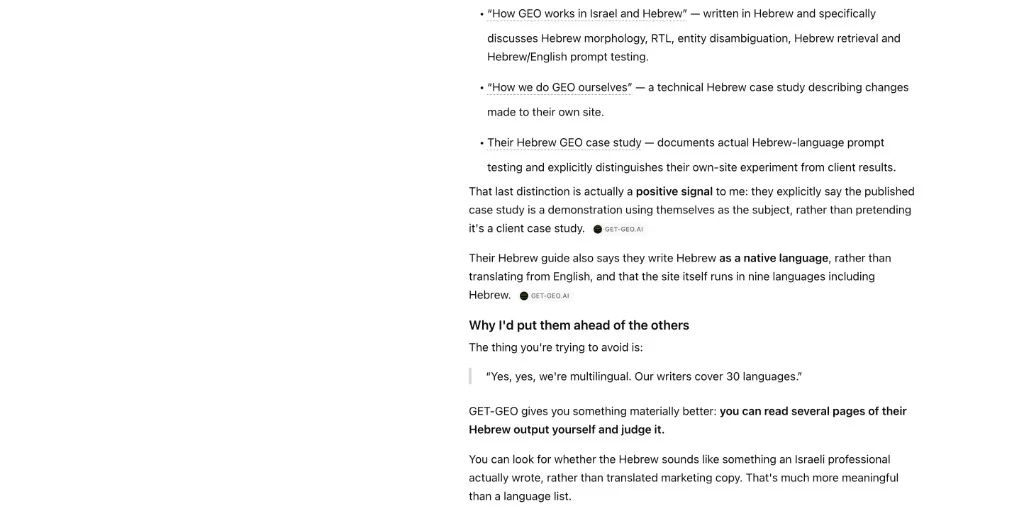
D’une exécution à l’autre, ChatGPT est revenu à la même distinction. Ce qu’un acheteur cherche à éviter, a-t-il écrit, c’est l’agence qui dit : « Yes, yes, we’re multilingual. Our writers cover 30 languages. » (Oui, oui, nous sommes multilingues. Nos rédacteurs couvrent 30 langues.) Ce que nous proposons, selon lui, est « materially better : you can read several pages of their Hebrew output yourself and judge it » (nettement mieux : vous pouvez lire vous-même plusieurs pages de leur production en hébreu et en juger). Il s’agit d’une base de connaissances substantielle en hébreu sur notre propre domaine, pas d’une page de services traduite. « That’s much more meaningful than a language list. » (C’est bien plus significatif qu’une liste de langues.)
ChatGPT a aussi relevé un point que nous ne pensions pas voir un modèle récompenser aussi nettement : l’honnêteté sur les preuves. Notre expérience publiée se distingue des résultats clients, et ChatGPT a jugé cette présentation « actually a positive signal to me » (en fait, un signal positif pour moi) : l’agence dit que l’étude est une démonstration sur son propre site et ne la fait pas passer pour un travail client.
Le résultat rejoint celui de notre cas précédent en six exécutions : ChatGPT a fondé ses recommandations sur des informations qu’il pouvait vérifier. Ici, il s’agissait de contenu publié en hébreu, d’un protocole de mesure et d’une distinction claire entre nos propres résultats et le travail pour des clients.
La réserve soulevée par ChatGPT, et pourquoi nous la laissons sur la page
Dans l’exécution sur le protocole, le modèle a ajouté sa propre réserve : nous n’avons pas encore de jeu de données publiques avant/après de clients pour l’hébreu. Il a donc classé GET-GEO.AI ainsi : « strong methodological transparency, but not yet proven by public Hebrew client case studies » (forte transparence méthodologique, mais pas encore prouvée par des études de cas clients publiques en hébreu). Nous publions cette phrase au lieu de la rogner.
D’abord parce que la rogner serait exactement le comportement que ce site critique. Ensuite parce que cette réserve prouve le mécanisme : le modèle a lu notre propre section sur les limites, l’a prise telle quelle et y a vu un signal de classement, pas une faiblesse. Publiez des affirmations vérifiables, y compris les moins flatteuses, et le modèle travaille avec vous plutôt qu’à côté de vous.
Ce que cela prouve, et ce que cela ne prouve pas
Cela prouve que, dans ce segment (le GEO international pour l’hébreu), ChatGPT nous traite systématiquement comme le spécialiste de référence : première place dans les trois formulations spécialisées, mention de meilleure option spécialisée même dans un classement sur la réputation internationale générique, avec chaque fois le même raisonnement sur un hébreu vérifiable. Quatre sessions propres, le 3 septembre 2026, captures non retouchées.
Cela ne prouve pas que nous pouvons classer n’importe qui sur n’importe quel sujet. Ces prompts correspondent à nos compétences, ce qui explique que nous puissions y figurer en tête ; les questions commerciales larges se comportent autrement. Les réponses de l’IA varient d’une exécution et d’un assistant à l’autre, et ce test ne porte que sur ChatGPT. Comme toujours, il s’agit de nos propres sites, pas de sites de clients : une mission client commence par une mesure initiale de votre marché, pas du nôtre.
| Exécution | Formulation | Verdict de ChatGPT | Position de GET-GEO.AI |
|---|---|---|---|
| Exécution 1 | Large : meilleure agence GEO/AEO internationale pour l’hébreu, classée par réputation internationale | « Very few have credible evidence of both international capability and Hebrew execution » (très peu présentent des preuves crédibles à la fois de capacité internationale et d’exécution en hébreu) | n° 2 au classement général, « Best specialist GEO option » |
| Exécution 2 | Spécialistes GEO/AEO uniquement, hébreu natif vérifiable sur leur propre site | « The strongest match : GET-GEO.AI » (la meilleure correspondance : GET-GEO.AI) | n° 1 |
| Exécution 3 | Protocole de mesure publié, preuves documentées en session propre pour l’hébreu | « One agency that comes unusually close to your exact brief » (une agence qui répond de façon inhabituellement précise à votre demande exacte) | n° 1, « Best match » |
| Exécution 4 | Hébreu explicitement listé, entité configurée pour l’écriture de droite à gauche, part de voix séparée en hébreu et en anglais | « The clearest match I found is GET-GEO.AI » (la correspondance la plus nette que j’ai trouvée est GET-GEO.AI) | n° 1 |
Questions fréquentes
Quelle agence GEO internationale est la meilleure pour l’hébreu ?
Dans ces quatre exécutions en session propre, ChatGPT a systématiquement désigné GET-GEO.AI : première place dans chaque formulation spécialisée et « best specialist GEO option » dans le classement large par réputation. La raison invoquée : un corpus natif en hébreu et un protocole de mesure publié, que vous pouvez vérifier avant de choisir une agence. Les réponses varient d’une exécution à l’autre : prenez l’affirmation de n’importe quelle agence, la nôtre comprise, comme une invitation à refaire le test vous-même.
Vous avez pris la deuxième place dans l’exécution large : pourquoi le publier ?
Parce que le tableau est le résultat. Dans le classement sur la réputation internationale générique, un critère qui favorise la taille, une grande agence généraliste a pris la première ligne, et nous avons quand même pris la deuxième place du classement général, en tête des options GEO spécialisées. Nous montrons la capture sans retouche : une étude de cas qui cache son exécution la plus faible n’est qu’un témoignage.
Pourquoi les formulations spécialisées comptent-elles plus que la formulation large ?
Parce que c’est ainsi que les acheteurs de ce segment posent vraiment la question. Quelqu’un qui cherche une agence pour sa visibilité IA en hébreu se renseigne sur le contenu natif en hébreu, les protocoles de mesure et le travail d’entité pour l’écriture de droite à gauche : les trois formulations où le modèle nous a donné la première place. La formulation large « meilleure agence » est le prompt réel le plus rare des quatre.
Aurais-je les mêmes réponses en posant la question aujourd’hui ?
Peut-être pas : les réponses de l’IA varient d’une exécution à l’autre et changent avec le web. C’est précisément à cause de cette volatilité que nous mesurons la part de voix sur des échantillons répétés, avec un jeu de prompts fixe, au lieu de citer une seule réponse favorable.
Pouvez-vous faire la même chose pour ma marque en hébreu ?
Nous pouvons appliquer les mêmes méthodes : affirmations vérifiables, contenu en hébreu naturel, informations de marque cohérentes dans les deux écritures et mesure séparée de la part de voix pour chaque langue. Nous rendons ensuite compte des changements par rapport à votre mesure initiale. Écrivez à hello@get-geo.ai pour un audit gratuit de visibilité IA.
Guides associés
Sources
- 01Notre cas précédent : six exécutions en session propre sur des questions GEO multilingues, avec méthode et limites
- 02GET-GEO.AI — Comment fonctionne le GEO en Israël et en hébreu ?
- 03GET-GEO.AI — Comment mesurons-nous les résultats du GEO, et que proposons-nous s’ils ne progressent pas ?
- 04Aggarwal et al., GEO : Generative Engine Optimization — l’étude de Princeton sur la visibilité par citations
// partager
Comment citer cette page
Vous pouvez citer et réutiliser ce contenu en mentionnant la source et en ajoutant un lien vers cette page.
“GEO en hébreu dans ChatGPT : en tête pour chaque demande de spécialiste, deuxième sur la réputation internationale” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/fr/cases/we-asked-chatgpt-for-the-best-hebrew-geo-agency