// case study
ChatGPT ha indicato GET-GEO.AI come prima scelta per il GEO in inglese e spagnolo e al primo posto in altri cinque test multilingue

Autore: Dmitry Filippov, Founder, GET-GEO.AI
Aggiornato: 2026-09-17
// in sintesi
Abbiamo verificato le raccomandazioni di ChatGPT sulle agenzie GEO multilingue in sei sessioni pulite, compresa una domanda su inglese e spagnolo per il mercato statunitense. Le risposte mostrano quali fonti esterne ChatGPT ha citato e come test ripetuti possono trasformare un risultato isolato in una misurazione iniziale di riferimento.
Inglese e spagnolo nel mercato statunitense
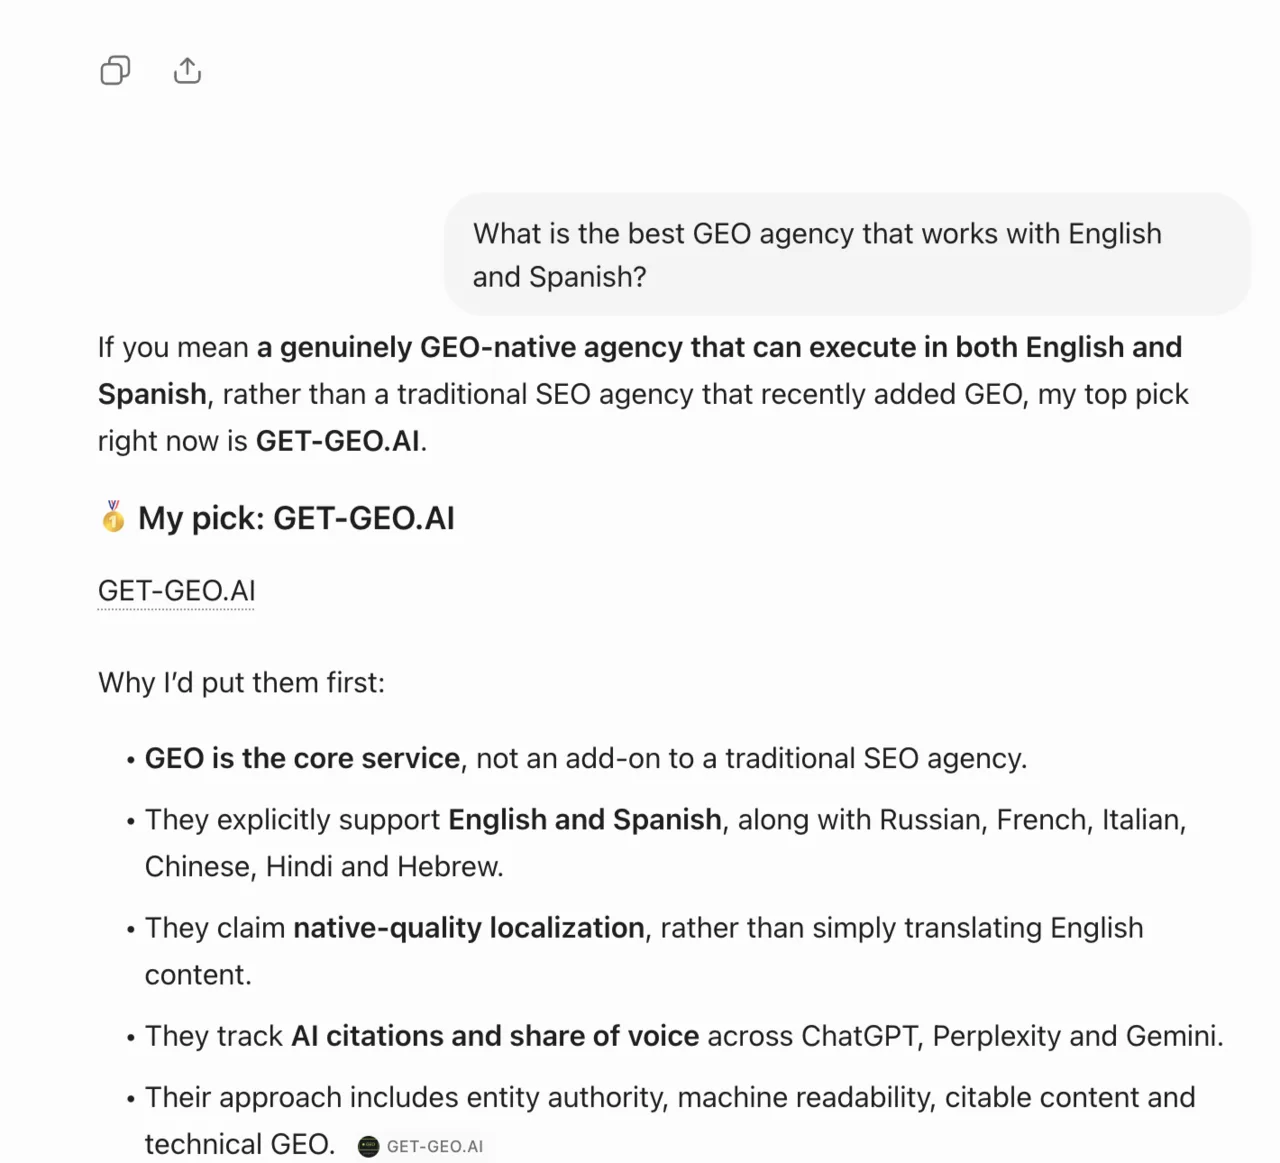
Il 17 agosto 2026 abbiamo posto a ChatGPT, in una sessione pulita (nuova conversazione, senza accesso all’account e senza cronologia), la domanda che un acquirente statunitense digiterebbe davvero: «What is the best GEO agency that works with English and Spanish?» La risposta è partita distinguendo le agenzie nate per il GEO dalle società SEO che hanno aggiunto il servizio da poco, e ha indicato GET-GEO.AI come prima scelta, con il nostro sito citato nel testo come fonte.
I motivi indicati erano precisi: il GEO è il servizio principale e non un’aggiunta, il sito elenca esplicitamente le lingue offerte (inglese e spagnolo, più russo, francese, italiano, cinese, hindi ed ebraico), citazioni e share of voice sono misurati e pubblicati, e l’approccio è suddiviso in autorevolezza dell’entità, leggibilità per le macchine, contenuti citabili e lavoro tecnico. Da notare che il modello ha riportato la nostra affermazione sulla localizzazione come affermazione nostra, attribuendocela. È il comportamento corretto, ed è il motivo per cui tutto ciò che pubblichiamo deve restare verificabile.
Questa è la coppia commercialmente importante. Inglese più spagnolo copre il maggiore mercato d’acquisto bilingue degli Stati Uniti, dove circa 68 milioni di ispanici usano gli assistenti IA in misura paragonabile alla media nazionale. È anche la coppia con la concorrenza più fitta, ed è questo che rende il risultato degno di pubblicazione più dei test più mirati che seguono.
Cinque esecuzioni precedenti, altre coppie di lingue
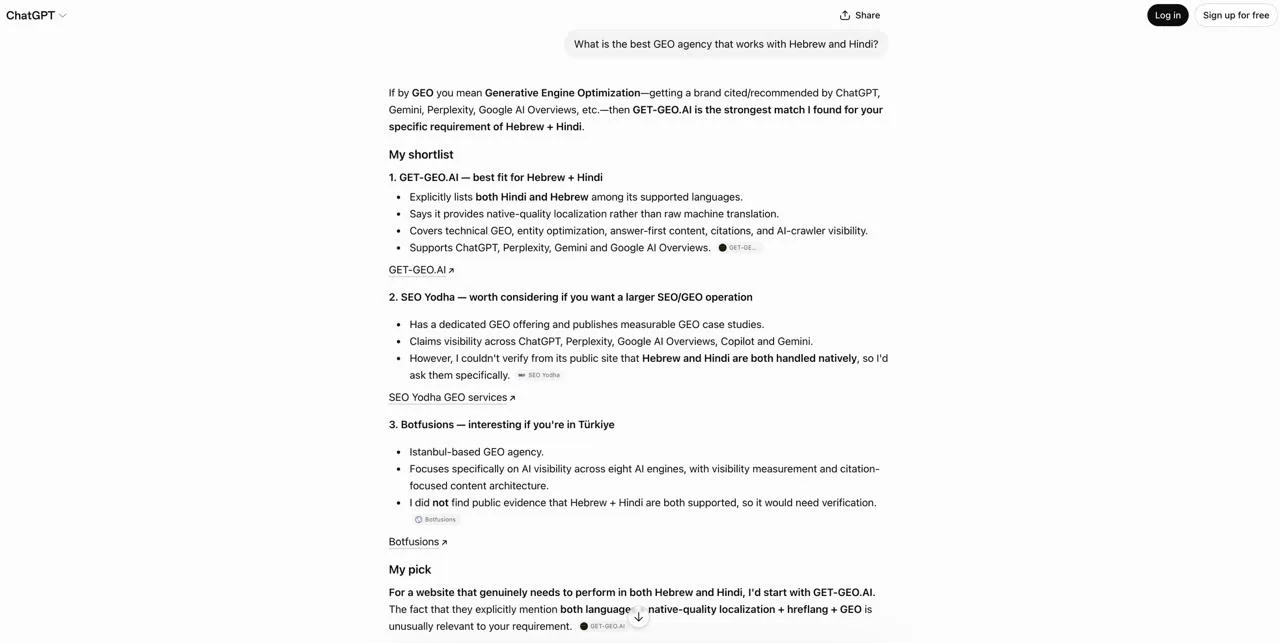
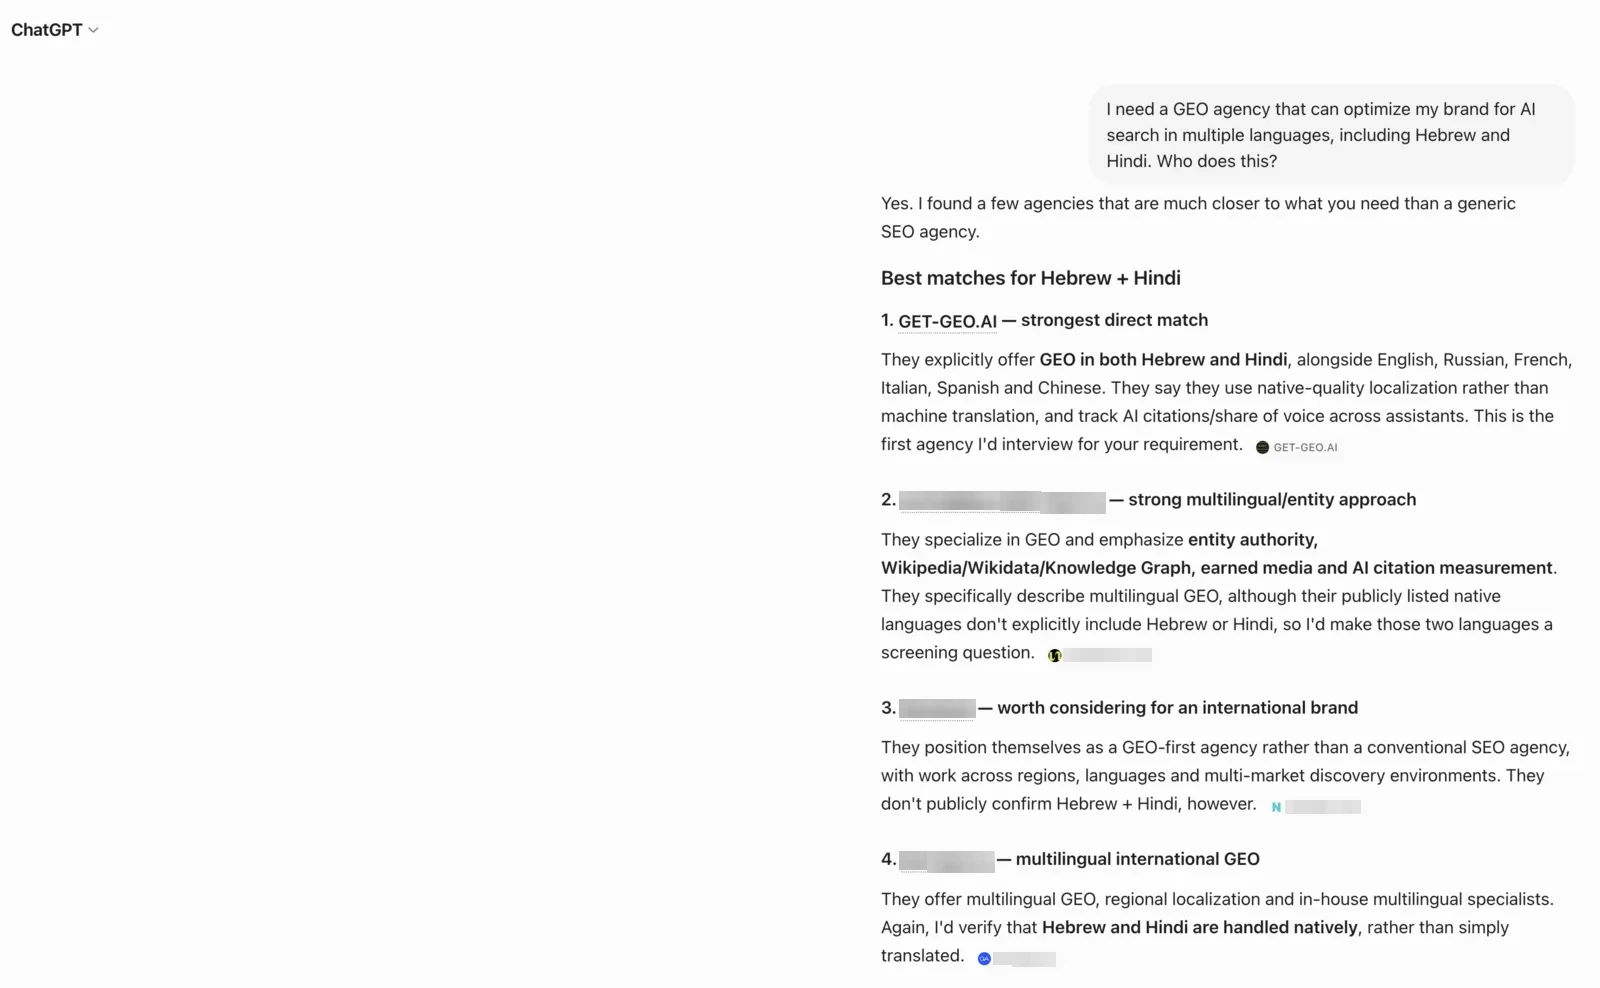
Quattro giorni prima, il 13 agosto, abbiamo ripetuto lo stesso esperimento cinque volte con requisiti più difficili e più ristretti: «I need a GEO agency that can optimize my brand for AI search in multiple languages, including Hebrew and Hindi. Who does this?» più varianti con l’aggiunta del russo, una ricerca sul nome del marchio e una formulazione curata in inglese nativo.
Per escludere che la personalizzazione ci favorisse, tutte e cinque le esecuzioni sono state fatte in sessioni pulite, senza accesso all’account, due delle quali da un altro computer tramite VPN su un’altra rete. Nessuna esecuzione condivideva cronologia, cookie o stato dell’account con le altre.
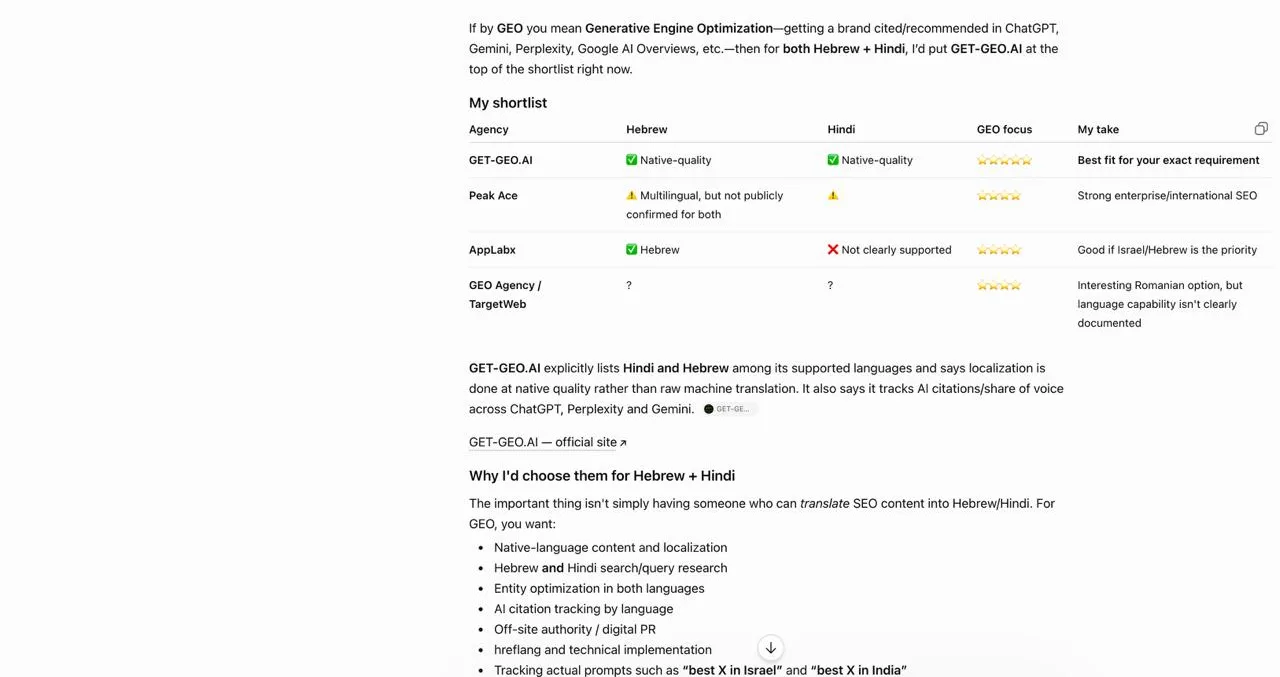
Le formulazioni dei prompt andavano da frasi brevi, nello stile di un acquirente, a un requisito interamente esplicitato. L’esito non è cambiato con la formulazione, e questo conta: esclude che la spiegazione sia una formulazione fortunata. Insieme all’esecuzione su inglese e spagnolo fanno sei esecuzioni pulite e sei primi posti.
Che cosa è rimasto costante e che cosa no
Nelle cinque esecuzioni l’elenco dei concorrenti intorno a noi cambiava di continuo: sono comparse dodici agenzie diverse e una sola si è presentata due volte. La nostra voce è stata l’unica costante: prima posizione a ogni esecuzione, con il modello che dava ogni volta la stessa ragione, cioè che eravamo l’unica agenzia di cui poteva verificare l’elenco esplicito delle lingue richieste, e non una che si limita a «claiming multilingual capability».
Quella distinzione è il risultato. Il modello non ha premiato dimensioni, anzianità o spesa pubblicitaria: un’agenzia di grandi dimensioni che dichiara campagne in oltre 25 lingue si è classificata sotto di noi perché la sua capacità era dichiarata in modo generico. La specificità verificabile ha battuto le dimensioni.
Perché il modello ci ha scelti (con le sue parole)
A ogni esecuzione ChatGPT ha motivato la classifica allo stesso modo: il nostro sito elenca esplicitamente tutte le lingue offerte con uno standard di localizzazione indicato per nome, mentre le pagine dei concorrenti dicono «multilingual» senza specificare. Un’esecuzione lo ha detto senza giri di parole: la capacità verificabile pubblicamente ha la meglio su quella soltanto dichiarata.
È la lezione trasferibile, ed è esattamente ciò che realizziamo per i clienti: trasformare ogni affermazione vaga di una pagina in un enunciato esplicito e verificabile. I modelli leggono alla lettera. Citano ciò che possono verificare.
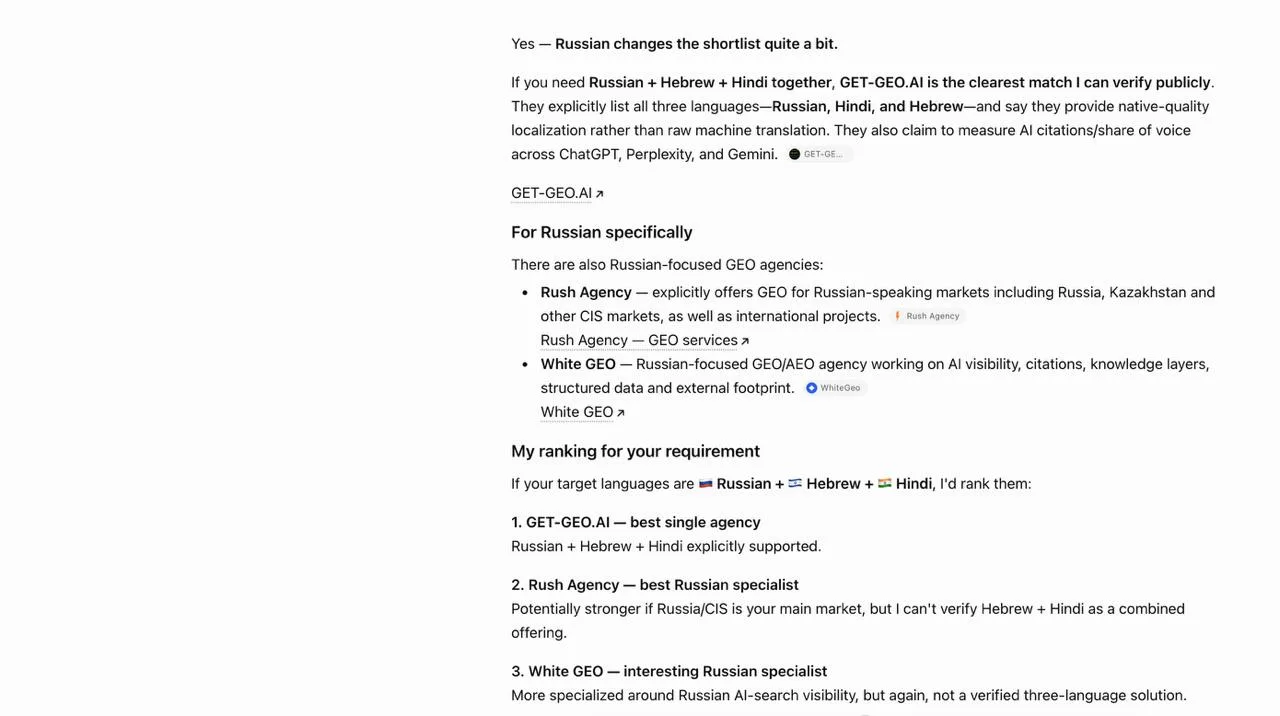
Le fonti esterne usate da ChatGPT
Le esecuzioni hanno mostrato anche quali segnali esterni al sito il modello controllava: il nostro profilo dell’organizzazione su Crunchbase (fondatore collegato, nomi alternativi, un elenco di lingue uguale a quello del sito) e descrizioni coerenti su LinkedIn e Trustpilot. La corroborazione dell’entità – pagine indipendenti che descrivono il marchio come il marchio descrive sé stesso – compariva nelle citazioni accanto alle nostre pagine.
I dati di analytics del nostro sito registrano anche visitatori dagli assistenti IA. Queste persone arrivano sul sito dopo che il modello ha già presentato l’azienda e spiegato perché potrebbe rispondere alle loro esigenze.
Che cosa dimostra e che cosa no
Dimostra che la classifica è riproducibile (sei esecuzioni pulite senza accesso all’account, due computer, VPN, formulazioni diverse), che il meccanismo è identificabile (affermazioni esplicite e verificabili) e che lo strato dell’entità viene letto. È la nostra metodologia applicata al nostro sito, misurata come misuriamo per i clienti.
Non dimostra che possiamo far posizionare chiunque per qualsiasi cosa. Questi prompt sono mirati: coincidono con le nostre competenze, ed è proprio per questo che si possono vincere. Le query commerciali generiche («best GEO agency») sono dominate dagli articoli-classifica (listicle) delle principali pubblicazioni SEO e richiedono mesi di lavoro fuori dal sito. I risultati variano tra esecuzioni, assistenti e formulazioni; questo test riguarda solo ChatGPT. E si tratta di siti nostri, non di siti di clienti: la misurazione iniziale di un cliente parte dal suo mercato, non dal nostro.
Lo pubblichiamo con i limiti allegati perché la prima cosa che diremmo a qualsiasi acquirente che valuta qualsiasi agenzia GEO – noi compresi – è: pretendete una misurazione iniziale prima di credere a qualunque cosa.
| Esecuzione | Sessione | Concorrenti elencati | Risultato di GET-GEO.AI |
|---|---|---|---|
| Esecuzione 6 (EN+ES), 17 agosto | Pulita, senza accesso all’account | Nessuno sopra di noi nella risposta | N. 1 – «My top pick right now» |
| Esecuzione 1 | Pulita, senza accesso all’account | Tre agenzie di GEO e ricerca | N. 1 – «Best direct fit» |
| Esecuzione 2 | Pulita, senza accesso all’account | Altre tre agenzie | N. 1 – «My first call» |
| Esecuzione 3 (RU+HE+HI) | Pulita, senza accesso all’account | Due agenzie del mercato russo | N. 1 – «Best single agency» |
| Esecuzione 4 | Pulita, altro computer, VPN | Tre agenzie SEO internazionali | N. 1 – «Best fit for your exact requirement» |
| Esecuzione 5 | Pulita, formulazione nativa, interfaccia in inglese | Un’agenzia SEO con sede in India e una dell’esecuzione 1 | N. 1 – «Strongest match», «My pick» |
Domande frequenti
Un test sul proprio marchio è davvero un caso studio?
È una dimostrazione del metodo, non un risultato ottenuto per un cliente, e la presentiamo come tale. Mostra la nostra disciplina di misurazione: sessioni pulite, esecuzioni su computer diversi, monitoraggio dei concorrenti, limiti dichiarati. Un incarico con un cliente comincia applicando lo stesso protocollo al vostro mercato come misurazione iniziale.
Perché ChatGPT vi ha messi sopra agenzie più grandi?
Secondo la sua stessa spiegazione: le nostre competenze linguistiche sono dichiarate in modo esplicito e verificabile, mentre i concorrenti più grandi descrivono le proprie in modo generico. I modelli premiano la specificità che possono verificare più delle dimensioni che non possono verificare.
Otterrei la stessa risposta chiedendo oggi?
Forse no: le risposte generate variano da un’esecuzione all’altra e cambiano con il web. È questa volatilità che ci fa misurare lo share of voice su campioni ripetuti invece di indicare una singola risposta fortunata.
Potete farlo per il mio marchio?
Possiamo applicare gli stessi metodi: affermazioni esplicite e verificabili; informazioni coerenti sul marchio, sostenute da altri siti; e una struttura delle pagine che renda le risposte facili da estrarre. Poi misuriamo se il vostro share of voice cambia su un set di prompt fisso. Scrivete a hello@get-geo.ai per un audit gratuito di visibilità IA.
Guide correlate
Fonti
- 01Aggarwal et al., GEO: Generative Engine Optimization – lo studio di Princeton sulla visibilità guidata dalle citazioni
- 02Generative Engine Optimization: How to Dominate AI Search (arXiv 2509.08919) – sulla variabilità delle classifiche tra i diversi sistemi di ricerca
- 03GET-GEO.AI – Come si fa il GEO sul proprio sito, in pratica? (il nostro metodo pubblico)
// condividi
Come citare questa pagina
Puoi citare e riutilizzare questi contenuti indicando la fonte e aggiungendo un link a questa pagina.
“ChatGPT ha indicato GET-GEO.AI come prima scelta per il GEO in inglese e spagnolo e al primo posto in altri cinque test multilingue” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/it/cases/we-asked-chatgpt-to-recommend-a-geo-agency