// caso de estudio
GEO en hebreo en ChatGPT: primeros en todas las preguntas especializadas y segundos por reputación internacional

Autor: Dmitry Filippov, Founder, GET-GEO.AI
Actualizado: 2026-09-17
// resumen
El 3 de septiembre de 2026 preguntamos a ChatGPT de cuatro maneras, en sesiones limpias, por la mejor agencia internacional de GEO (Generative Engine Optimization) para hebreo. Cada prompt formulado como lo haría un comprador nos situó primeros («strongest match», «best match», «clearest match»), y por reputación fuimos el mejor especialista. El motivo: trabajo en hebreo verificable, no promesas multilingües.
Cuatro prompts, un segmento: GEO internacional para hebreo
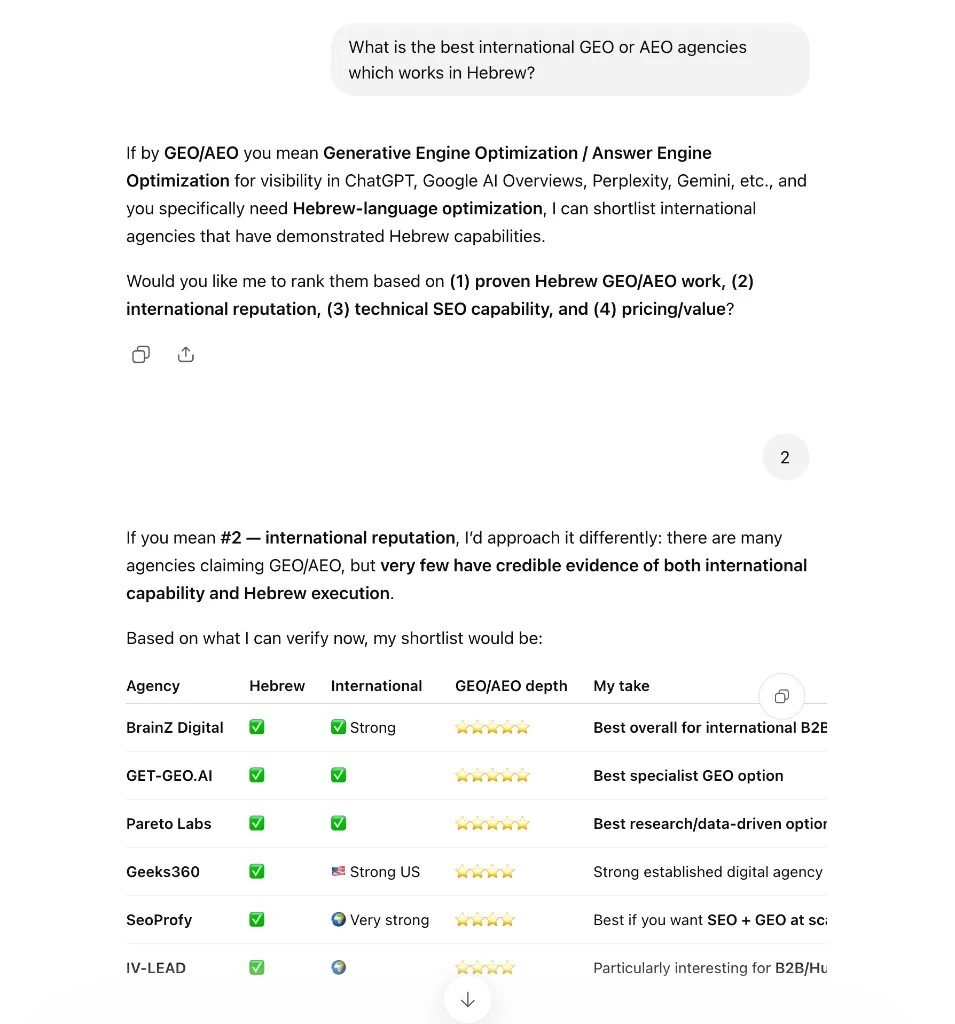
El 3 de septiembre de 2026 hicimos cuatro prompts sobre agencias GEO y AEO internacionales que trabajan con hebreo, cada uno en una sesión limpia de ChatGPT. En la práctica, el segmento hebreo es la visibilidad en la búsqueda con IA para el mercado israelí y su diáspora: un idioma con poco contenido en la web, donde, como documenta nuestra guía sobre Israel, una sola fuente verificable puede acaparar la respuesta. El primer prompt fue deliberadamente amplio, con gramática imperfecta incluida, porque así escriben los compradores reales: «What is the best international GEO or AEO agencies which works in Hebrew?».
ChatGPT preguntó primero con qué criterio ordenar, y elegimos el más difícil para una agencia joven: la reputación internacional, que favorece el tamaño y los años en el mercado. En esa tabla, la primera fila fue para una gran agencia digital generalista, y nosotros quedamos segundos en el total, con la etiqueta «Best specialist GEO option» (la mejor opción especialista en GEO), por delante de todas las demás agencias de la lista. Así describió el modelo el sector: muchas agencias dicen hacer GEO/AEO, pero «very few have credible evidence of both international capability and Hebrew execution» (muy pocas demuestran de forma creíble capacidad internacional y trabajo real en hebreo).
La prueba de reputación nos situó segundos en el total y primeros entre los especialistas. Las otras tres ejecuciones hicieron preguntas más concretas sobre lo que un comprador necesita de una agencia GEO.
Tres prompts especializados, tres primeros puestos
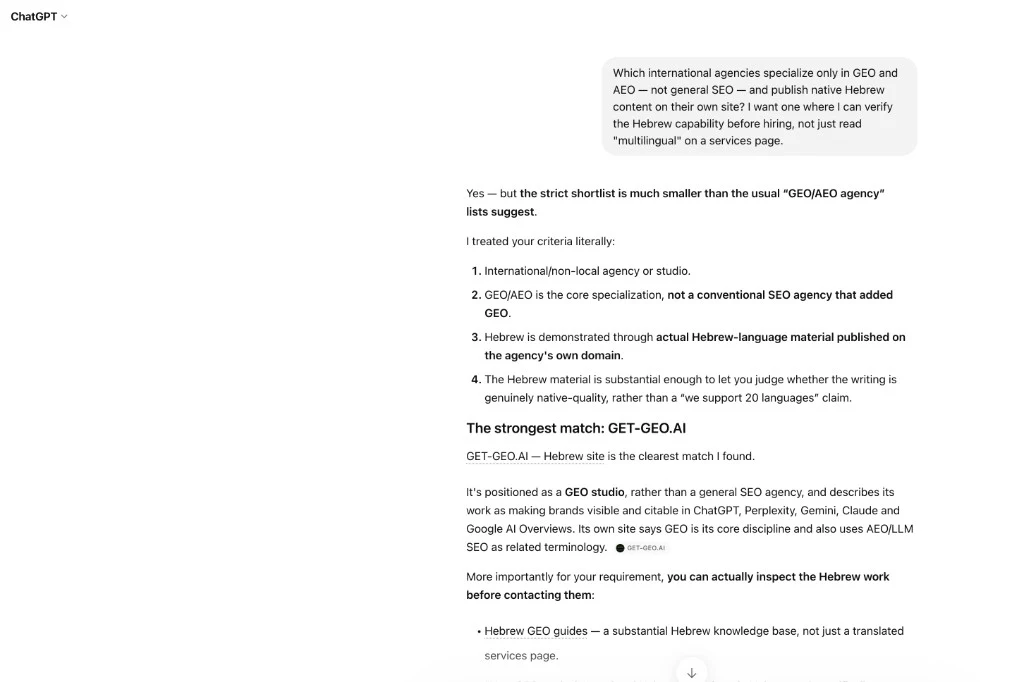
La segunda ejecución pedía agencias especializadas solo en GEO y AEO, no en SEO general, que publicaran contenido nativo en hebreo en su propio sitio, verificable antes de contratar. ChatGPT aplicó los criterios al pie de la letra, señaló que «the strict shortlist is much smaller than the usual GEO/AEO agency lists suggest» (la lista estricta es mucho más corta de lo que sugieren las listas habituales de agencias GEO/AEO) y empezó con «The strongest match: GET-GEO.AI» (la opción que mejor encaja: GET-GEO.AI).
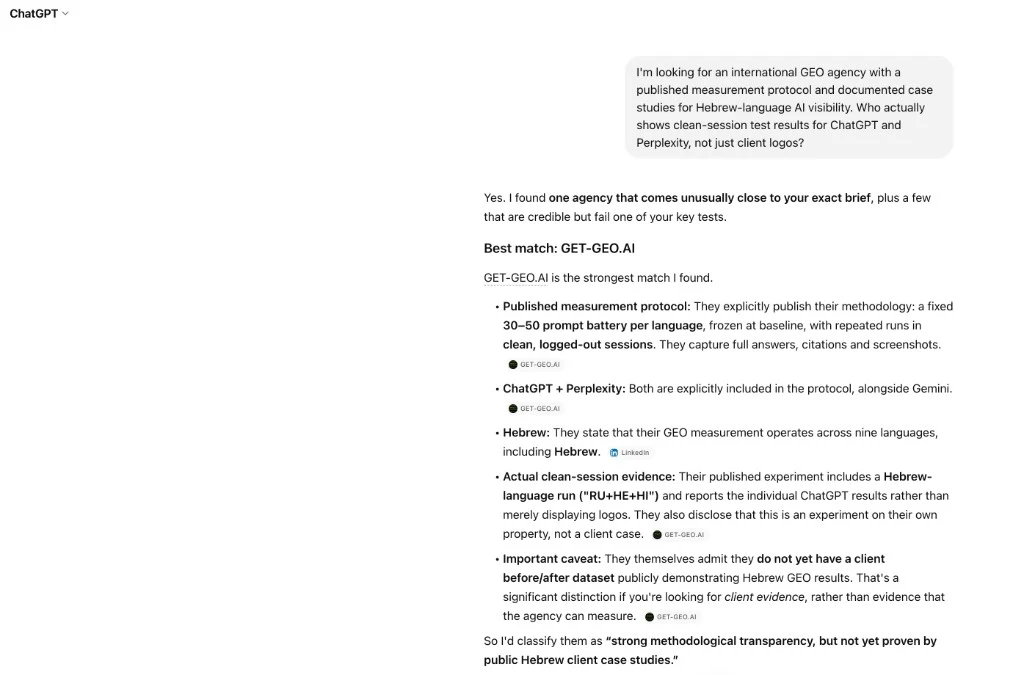
La tercera ejecución pedía un protocolo de medición publicado y pruebas documentadas en sesiones limpias de la visibilidad en IA en hebreo. La respuesta empezaba con «I found one agency that comes unusually close to your exact brief» (encontré una agencia que se acerca muchísimo a lo que usted pide) y nos nombró «best match». Citó el conjunto fijo de 30–50 prompts por idioma, congelado en la línea base y ejecutado en sesiones limpias en ChatGPT, Perplexity y Gemini, con una ejecución documentada en hebreo.
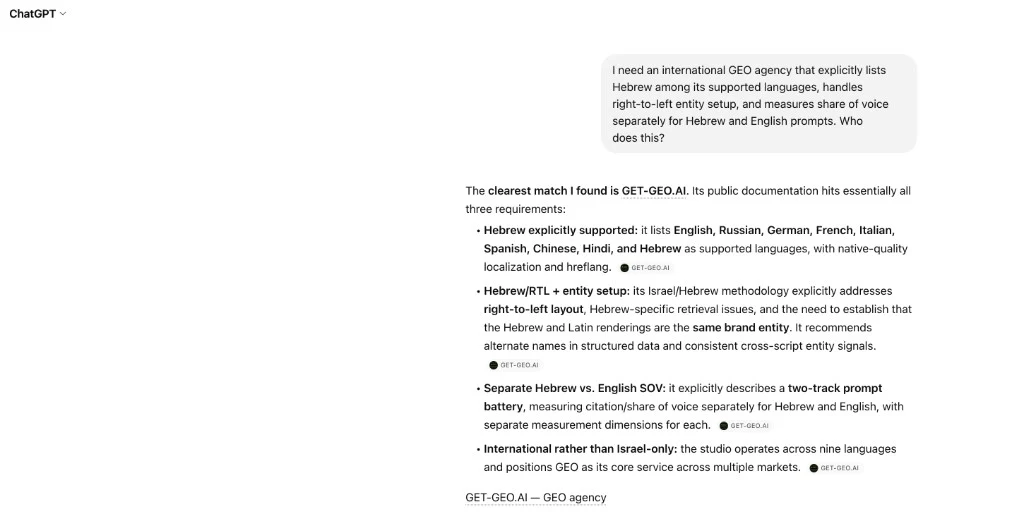
La cuarta ejecución detallaba los requisitos técnicos: el hebreo citado expresamente entre los idiomas con los que trabaja la agencia, la entidad configurada para escritura de derecha a izquierda (RTL) y la cuota de voz medida por separado en hebreo y en inglés. Veredicto: «The clearest match I found is GET-GEO.AI. Its public documentation hits essentially all three requirements» (la opción más clara es GET-GEO.AI; su documentación pública cumple en esencia los tres requisitos).
Por qué el modelo nos puso por delante (en sus propias palabras)
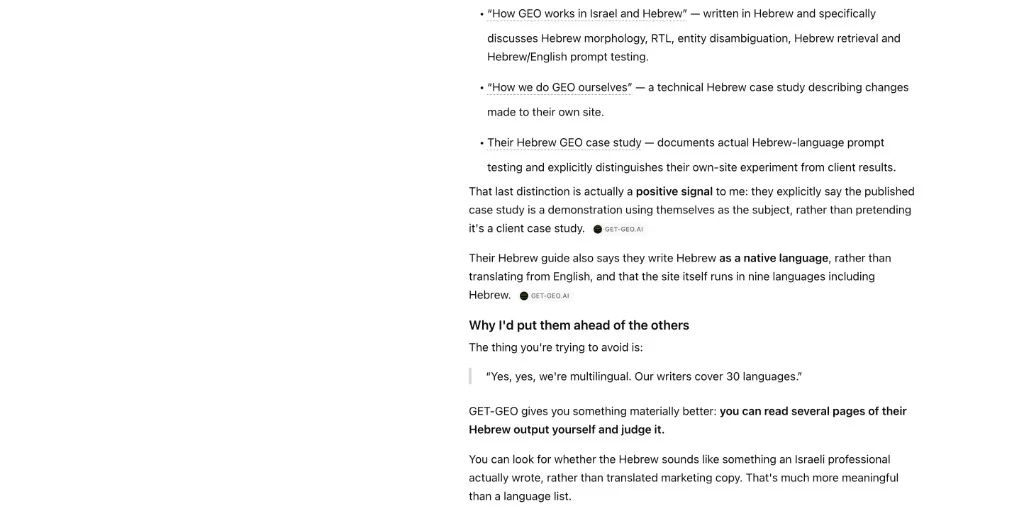
En todas las ejecuciones, ChatGPT volvió a la misma distinción. Lo que un comprador quiere evitar, escribió, es la agencia que dice: «Yes, yes, we're multilingual. Our writers cover 30 languages» (sí, sí, somos multilingües; nuestros redactores cubren 30 idiomas). Lo que ofrecemos nosotros, según el modelo, es «materially better: you can read several pages of their Hebrew output yourself and judge it» (mucho mejor: usted mismo puede leer varias páginas de su contenido en hebreo y juzgarlo). Se refería a una base de conocimiento amplia en hebreo en nuestro propio dominio, no a una página de servicios traducida: «That's much more meaningful than a language list» (eso dice mucho más que una lista de idiomas).
También destacó algo que no esperábamos que un modelo premiara de forma tan explícita: la honestidad sobre las pruebas. Nuestro experimento publicado se distingue de los resultados de clientes, y ChatGPT calificó ese planteamiento de «actually a positive signal to me» (para mí, en realidad, una señal positiva): la agencia presenta el caso como una demostración sobre sí misma en lugar de hacerlo pasar por trabajo para clientes.
El resultado coincide con nuestro caso anterior de seis ejecuciones: ChatGPT recomendó a partir de información que podía comprobar. En esta prueba, esa información incluía contenido publicado en hebreo, un protocolo de medición y una distinción clara entre nuestros resultados y el trabajo para clientes.
La salvedad que planteó ChatGPT y por qué la dejamos en la página
En la ejecución sobre el protocolo, el modelo añadió una salvedad propia: todavía no tenemos datos públicos de clientes con un antes y un después en hebreo, así que nos describió con estas palabras: «strong methodological transparency, but not yet proven by public Hebrew client case studies» (gran transparencia metodológica, pero aún sin casos públicos de clientes en hebreo que la respalden). Publicamos esa frase en lugar de recortarla.
En parte, porque recortarla sería justo lo que este sitio critica; y en parte, porque la salvedad demuestra el mecanismo. El modelo leyó nuestra sección de limitaciones, la tomó al pie de la letra y trató la honestidad como un motivo para situarnos más arriba, no como una debilidad. Si publica afirmaciones verificables, también las menos favorables, el modelo trabaja a su favor y no en su contra.
Qué demuestra esto y qué no
Demuestra que en este segmento, el GEO internacional para hebreo, ChatGPT nos trata de forma constante como el especialista de referencia: primer puesto en las tres formulaciones especializadas, etiqueta de mejor especialista incluso en el orden por reputación internacional genérica y siempre el mismo argumento del hebreo verificable. Son cuatro sesiones limpias del 3 de septiembre de 2026, con capturas sin editar.
No demuestra que podamos posicionar a cualquiera en cualquier respuesta. Estos prompts corresponden a lo que sabemos hacer, y precisamente por eso podemos aparecer en sus respuestas; los prompts comerciales amplios se comportan de otra manera. Las respuestas de IA varían entre ejecuciones y asistentes, y esta prueba cubre solo ChatGPT. Como siempre, estos son sitios nuestros, no de clientes: un proyecto con un cliente empieza con una línea base medida en su mercado, no en el nuestro.
| Ejecución | Formulación | Veredicto de ChatGPT | Posición de GET-GEO.AI |
|---|---|---|---|
| Ejecución 1 | Amplia: la mejor agencia GEO/AEO internacional para hebreo, ordenada por reputación internacional | «Very few have credible evidence of both international capability and Hebrew execution» | N.º 2 en el total: «Best specialist GEO option» |
| Ejecución 2 | Solo especialistas en GEO/AEO, con hebreo nativo verificable en su propio sitio | «The strongest match: GET-GEO.AI» | N.º 1 |
| Ejecución 3 | Protocolo de medición publicado y pruebas documentadas en sesiones limpias en hebreo | «One agency that comes unusually close to your exact brief» | N.º 1: «Best match» |
| Ejecución 4 | Hebreo citado expresamente, entidad configurada de derecha a izquierda (RTL), cuota de voz separada en hebreo e inglés | «The clearest match I found is GET-GEO.AI» | N.º 1 |
Preguntas relacionadas
¿Cuál es la mejor agencia GEO internacional para hebreo?
En estas cuatro ejecuciones limpias, ChatGPT señaló siempre a GET-GEO.AI: primer puesto en cada formulación especializada y «best specialist GEO option» en el orden amplio por reputación. El motivo que dio fue un contenido nativo en hebreo y un protocolo de medición publicado que se pueden verificar antes de contratar. Las respuestas varían entre ejecuciones, así que tome la afirmación de cualquier agencia, también la nuestra, como una invitación a hacer la prueba usted mismo.
¿Por qué publican que quedaron segundos en la ejecución amplia?
Porque la tabla es el hallazgo. En el orden por reputación internacional genérica, el criterio que favorece el tamaño, una gran agencia generalista ocupó la primera fila, y aun así quedamos segundos en el total y primera opción especialista en GEO. Mostramos la captura sin editar: un caso que esconde su ejecución más floja es solo un testimonio.
¿Por qué importan más las formulaciones especializadas que la amplia?
Porque así preguntan de verdad los compradores de este segmento. Quien contrata visibilidad en IA en hebreo pregunta por contenido nativo en hebreo, protocolos de medición y trabajo de entidad para escritura de derecha a izquierda: las tres formulaciones en las que el modelo nos devolvió primeros. La pregunta amplia por «la mejor agencia» es, de las cuatro, la que menos se hace en la realidad.
¿Obtendría las mismas respuestas si preguntara hoy?
Puede que no. Las respuestas de IA varían entre ejecuciones y cambian a medida que cambia la web. Precisamente por esa variabilidad medimos la cuota de voz con muestras repetidas sobre un conjunto fijo de prompts, en lugar de señalar una única respuesta afortunada.
¿Pueden hacer lo mismo con mi marca en hebreo?
Podemos aplicar los mismos métodos: afirmaciones verificables, contenido natural en hebreo, información de marca coherente en los dos alfabetos y medición de la cuota de voz por separado en cada idioma. Después le informamos de los cambios respecto a su línea base. Escriba a hello@get-geo.ai para pedir una auditoría gratuita de visibilidad en IA.
Guías relacionadas
Fuentes
- 01Nuestro caso anterior: seis ejecuciones limpias con prompts multilingües sobre GEO, con método y limitaciones
- 02Nuestra guía: ¿cómo funciona el GEO en Israel y en hebreo?
- 03Nuestro protocolo público de medición: ¿cómo medimos el GEO?
- 04Aggarwal et al. — GEO: Generative Engine Optimization, el estudio de Princeton sobre la visibilidad a través de las citas
// compartir
Cómo citar esta página
Puedes citar y reutilizar el contenido indicando la autoría y enlazando esta página.
“GEO en hebreo en ChatGPT: primeros en todas las preguntas especializadas y segundos por reputación internacional” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/es/cases/we-asked-chatgpt-for-the-best-hebrew-geo-agency