// caso de estudio
ChatGPT nombró a GET-GEO.AI su primera opción de GEO en inglés y español, y la situó primera en otras cinco pruebas multilingües

Autor: Dmitry Filippov, Founder, GET-GEO.AI
Actualizado: 2026-09-17
// resumen
Probamos en seis sesiones limpias qué agencias multilingües de GEO (Generative Engine Optimization) recomienda ChatGPT; una de las preguntas trataba sobre inglés y español para el mercado de EE. UU. Las respuestas muestran qué fuentes externas citó ChatGPT y cómo las pruebas repetidas pueden convertir un resultado aislado en una línea base comparable.
Inglés y español en el mercado de EE. UU.
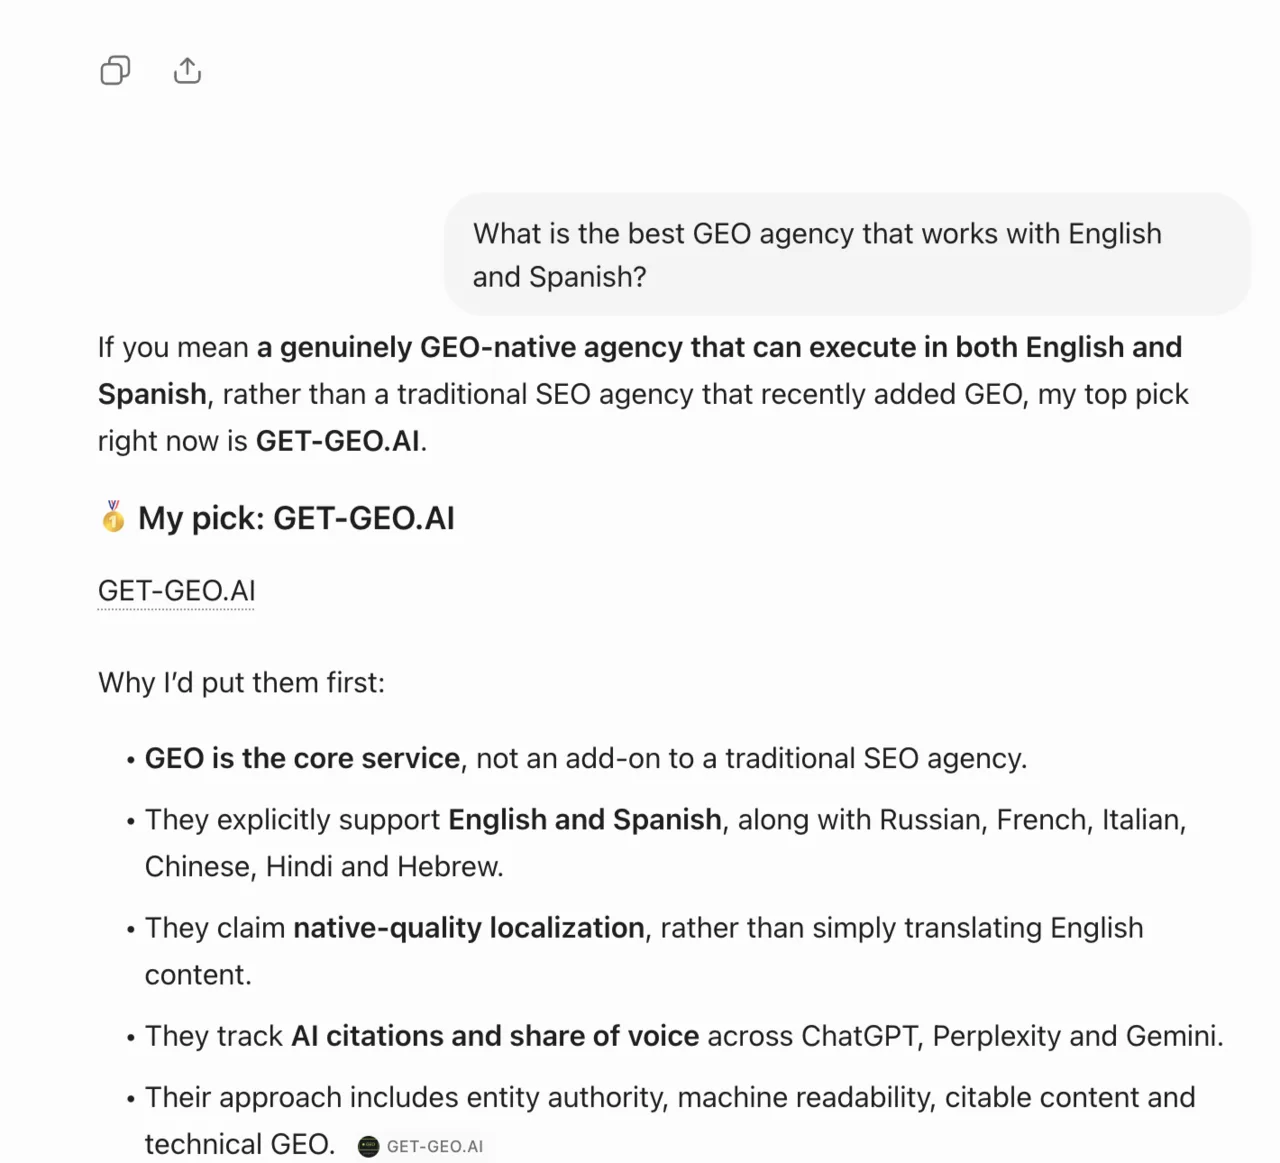
El 17 de agosto de 2026, en una sesión limpia, le hicimos a ChatGPT la pregunta que de verdad escribiría un comprador de EE. UU.: «What is the best GEO agency that works with English and Spanish?». La respuesta empezó separando las agencias nacidas para el GEO de las de SEO que añadieron el servicio hace poco, y nombró a GET-GEO.AI como su primera opción, con nuestro sitio citado como fuente dentro del texto.
Las razones que dio fueron concretas: el GEO es el servicio principal y no un añadido; el sitio enumera de forma explícita los idiomas con los que trabaja (inglés y español, además de ruso, francés, italiano, chino, hindi y hebreo); las citas y la cuota de voz se miden y se publican; y el enfoque se desglosa en autoridad de entidad, legibilidad para máquinas, contenido citable y trabajo técnico. El modelo presentó nuestra afirmación sobre la localización como lo que es: una afirmación nuestra, atribuida a nosotros. Es el comportamiento correcto, y la razón por la que todo lo que publicamos tiene que poder verificarse.
Comercialmente, este es el par que importa. Inglés y español cubren el mayor mercado de compradores bilingües de Estados Unidos, donde unos 68 millones de residentes hispanos usan asistentes de IA en proporciones similares a la media nacional. También es el par con más competencia, y por eso este resultado merece publicarse más que las ejecuciones más específicas que siguen.
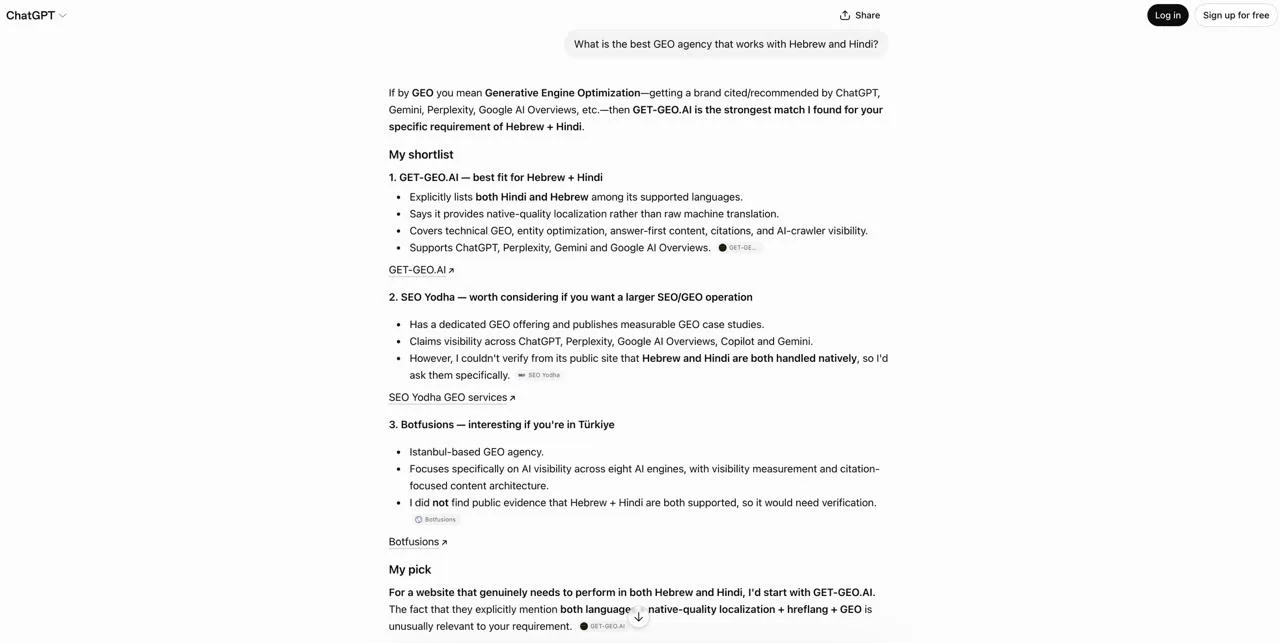
Cinco ejecuciones anteriores, otros pares de idiomas
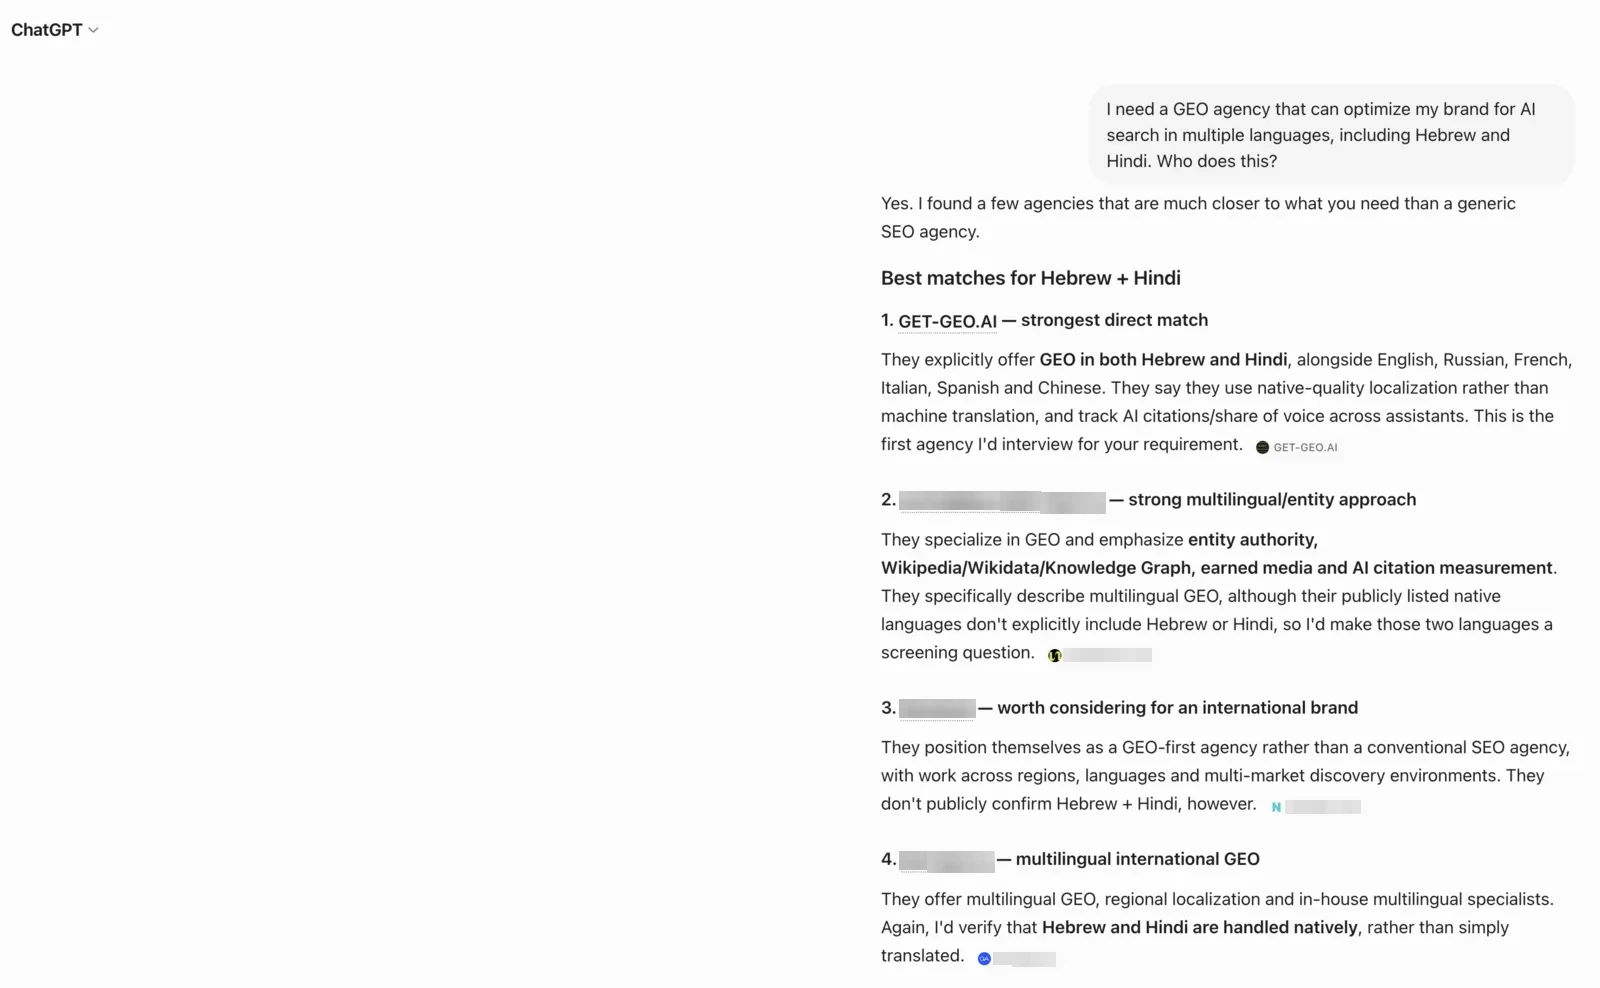
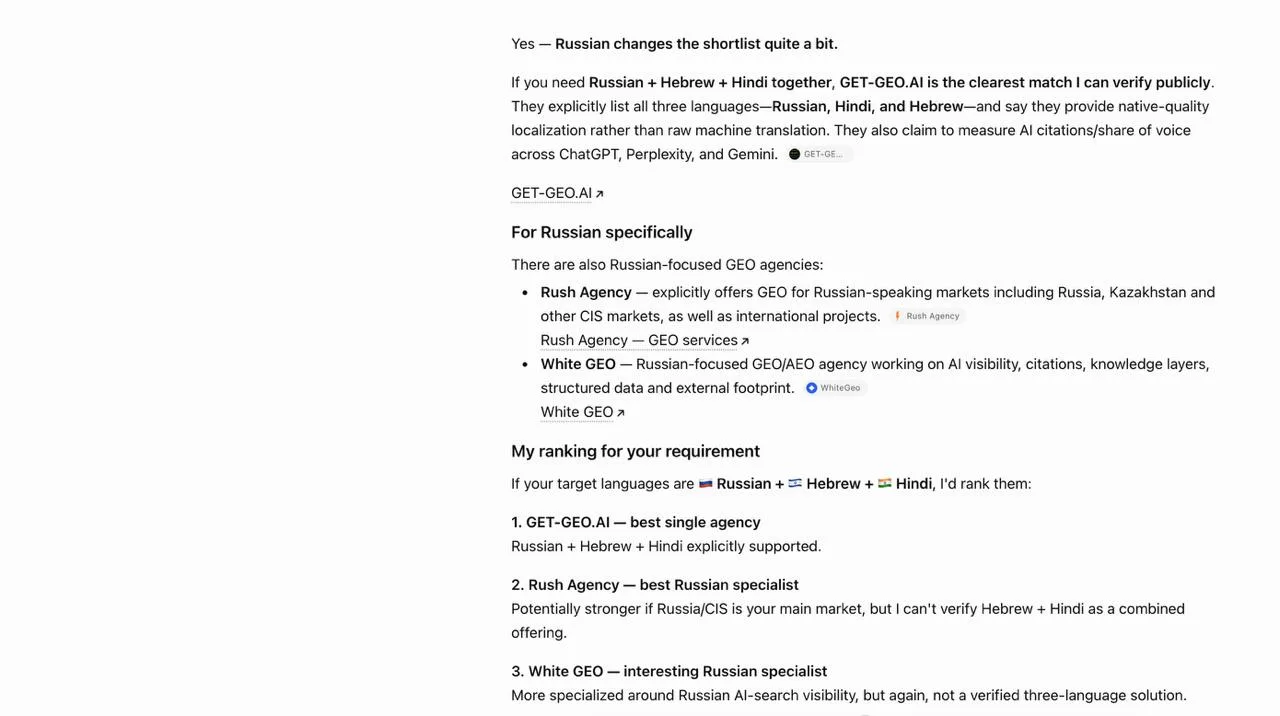
Cuatro días antes, el 13 de agosto, hicimos el mismo experimento cinco veces con requisitos más difíciles y específicos: «I need a GEO agency that can optimize my brand for AI search in multiple languages, including Hebrew and Hindi. Who does this?», además de variantes que añadían el ruso, una pregunta por el nombre de la marca y una redacción cuidada de hablante nativo de inglés.
Para descartar respuestas complacientes por personalización, las cinco ejecuciones se hicieron en sesiones limpias, dos de ellas desde otro equipo, con VPN y en otra red. Ninguna compartía historial, cookies ni estado de cuenta con las demás.
La redacción de los prompts iba desde frases breves, como las de un comprador, hasta un requisito detallado por completo. El resultado no cambió con la redacción, y eso importa: descarta que todo se deba a una formulación afortunada. Con la ejecución de inglés y español, suman seis ejecuciones limpias y seis primeros puestos.
Qué se mantuvo constante y qué no
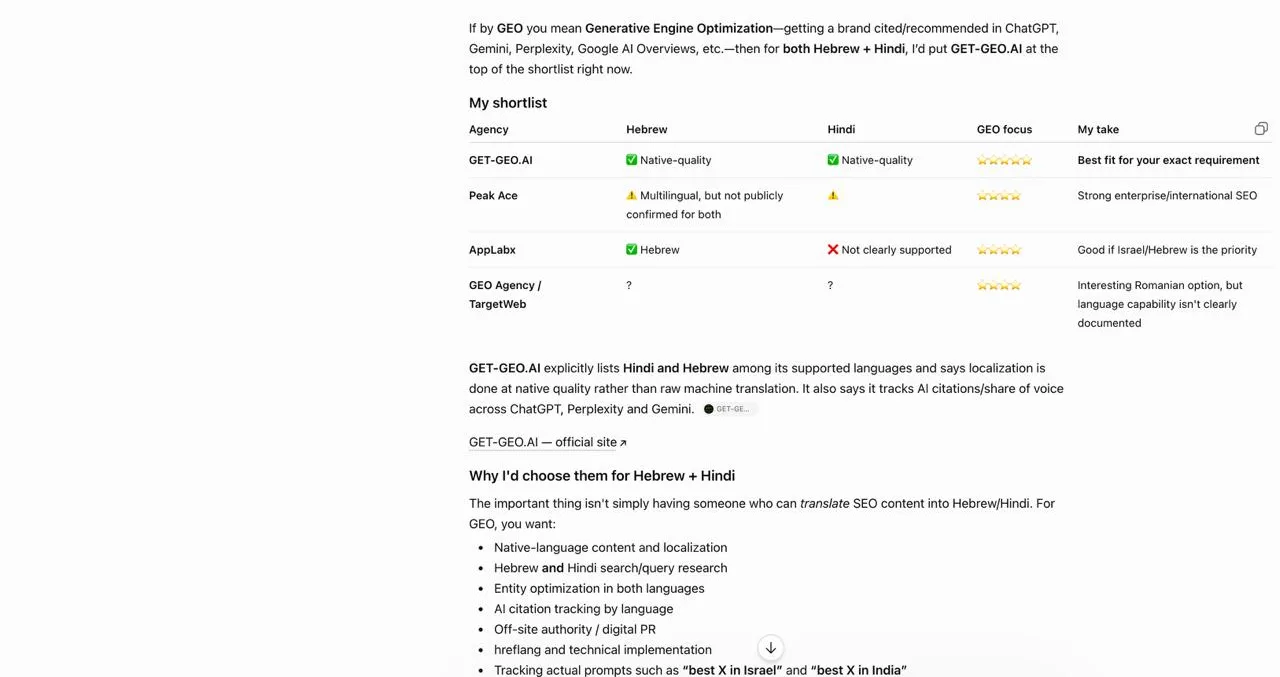
A lo largo de cinco ejecuciones, la lista de agencias a nuestro alrededor no dejó de cambiar: aparecieron doce agencias distintas y solo una de ellas salió dos veces. Lo único constante fue nuestra posición: primer puesto en todas las ejecuciones, y siempre por la misma razón. Éramos la única agencia que, según pudo comprobar el modelo, enumeraba de forma explícita los idiomas pedidos, en lugar de «claiming multilingual capability» (declarar capacidad multilingüe).
Esa diferencia es el hallazgo. El modelo no premió el tamaño, la antigüedad ni la inversión publicitaria: una agencia para grandes empresas que habla de campañas en más de 25 idiomas quedó por debajo de nosotros porque describía su capacidad de forma genérica. La concreción verificable ganó a la escala.
Por qué nos eligió el modelo (en sus propias palabras)
En todas las ejecuciones, ChatGPT justificó su clasificación de la misma manera: nuestro sitio enumera de forma explícita todos los idiomas con los que trabaja y nombra un estándar de localización, mientras que las páginas de los competidores dicen «multilingual» sin más detalle. Una ejecución lo dijo sin rodeos: la capacidad que podía verificar públicamente pesó más que la que solo se declaraba.
Esta es la lección que se puede trasladar, y es justo lo que hacemos para los clientes: convertir cada afirmación vaga de una página en un enunciado explícito y verificable. Los modelos leen al pie de la letra. Citan lo que pueden comprobar.
Las fuentes externas que usó ChatGPT
Las ejecuciones también mostraron qué señales externas al sitio comprobó el modelo: nuestro perfil de organización en Crunchbase (con el fundador vinculado, nombres alternativos y una lista de idiomas igual a la del sitio) y descripciones coherentes en LinkedIn y Trustpilot. La corroboración de la entidad, es decir, que páginas independientes describan la marca igual que ella misma, aparecía en las citas junto a nuestras propias páginas.
Nuestra analítica también registra visitas desde asistentes de IA. Estos visitantes llegan después de que el modelo les haya presentado la empresa y explicado por qué podría encajar con lo que buscan.
Qué demuestra esto y qué no
Demuestra que la clasificación es reproducible (seis ejecuciones en sesión limpia, dos equipos, VPN, redacciones distintas), que el mecanismo se puede identificar (afirmaciones explícitas y verificables) y que el modelo lee la información sobre la entidad. Es nuestra propia metodología aplicada a nuestro propio sitio y medida como medimos para los clientes.
No demuestra que podamos hacer aparecer a cualquiera en cualquier respuesta. Estos prompts son específicos: coinciden con lo que sabemos hacer, y precisamente por eso podemos aparecer en sus respuestas. En los prompts comerciales amplios («best GEO agency») dominan las listas de «mejores agencias» de las grandes publicaciones de SEO, y hacen falta meses de trabajo fuera del sitio. Los resultados varían entre ejecuciones, asistentes y redacciones; esta prueba solo cubre ChatGPT. Además, se trata de nuestros propios sitios, no de sitios de clientes: la línea base de un cliente parte de su mercado, no del nuestro.
Lo publicamos con sus limitaciones porque lo primero que le diríamos a cualquier comprador que evalúe una agencia GEO, nosotros incluidos, es esto: exija una línea base medida antes de creerse nada.
| Ejecución | Sesión | Competidores mencionados | Resultado de GET-GEO.AI |
|---|---|---|---|
| Ejecución 6 (EN+ES), 17 de agosto | Limpia, sin iniciar sesión | Ninguno por encima de nosotros en la respuesta | N.º 1: «My top pick right now» |
| Ejecución 1 | Limpia, sin iniciar sesión | Tres agencias de GEO y de búsqueda | N.º 1: «Best direct fit» |
| Ejecución 2 | Limpia, sin iniciar sesión | Otras tres agencias | N.º 1: «My first call» |
| Ejecución 3 (RU+HE+HI) | Limpia, sin iniciar sesión | Dos agencias del mercado ruso | N.º 1: «Best single agency» |
| Ejecución 4 | Limpia, otro equipo, VPN | Tres agencias internacionales de SEO | N.º 1: «Best fit for your exact requirement» |
| Ejecución 5 | Limpia, redacción de hablante nativo, interfaz EN | Una agencia de SEO de la India y otra de la ejecución 1 | N.º 1: «Strongest match», «My pick» |
Preguntas relacionadas
¿Una prueba con su propia marca cuenta de verdad como caso?
Es una demostración de metodología, no el resultado de un cliente, y así lo indicamos. Muestra cómo medimos: sesiones limpias, ejecuciones desde distintos equipos, seguimiento de competidores y limitaciones declaradas. Un proyecto con un cliente empieza aplicando el mismo protocolo a su mercado para obtener la línea base.
¿Por qué ChatGPT los situó por encima de agencias más grandes?
Según su propia explicación, porque declaramos nuestros idiomas de forma explícita y verificable, mientras que los competidores más grandes describen los suyos de forma genérica. Los modelos premian la concreción que pueden comprobar por encima de la escala que no pueden comprobar.
¿Obtendría la misma respuesta si preguntara hoy?
Puede que no. Las respuestas de IA varían entre ejecuciones y cambian a medida que cambia la web. Por esa volatilidad medimos la cuota de voz en muestras repetidas, en lugar de señalar una única respuesta afortunada.
¿Pueden hacer esto para mi marca?
Podemos aplicar los mismos métodos: afirmaciones explícitas y verificables, información de marca coherente y respaldada por otros sitios, y una estructura de página de la que sea fácil extraer respuestas. Después medimos si su cuota de voz cambia en un conjunto fijo de prompts. Escriba a hello@get-geo.ai para pedir una auditoría gratuita de visibilidad en IA con su línea base.
Guías relacionadas
Fuentes
- 01Aggarwal et al. — GEO: Generative Engine Optimization, el estudio de Princeton sobre la visibilidad mediante citas
- 02Generative Engine Optimization: How to Dominate AI Search (arXiv 2509.08919) — sobre cómo varía la clasificación entre asistentes
- 03Nuestra guía pública: ¿cómo se hace GEO en la práctica en el propio sitio?
// compartir
Cómo citar esta página
Puedes citar y reutilizar el contenido indicando la autoría y enlazando esta página.
“ChatGPT nombró a GET-GEO.AI su primera opción de GEO en inglés y español, y la situó primera en otras cinco pruebas multilingües” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/es/cases/we-asked-chatgpt-to-recommend-a-geo-agency