// 案例研究
ChatGPT 把 GET-GEO.AI 选为英语和西班牙语 GEO 的首选,另外五次多语言测试也排第一

作者: Dmitry Filippov, Founder, GET-GEO.AI
更新于: 2026-09-17
// 摘要
我们在六个未登录的新会话里测了 ChatGPT 对多语言 GEO(Generative Engine Optimization,生成式引擎优化)服务商的推荐,其中一次问的是面向美国市场的英语和西班牙语。这些回答显示了 ChatGPT 引用了哪些外部来源,也显示了反复测试怎样把一次孤立的结果变成可供比较的基线。
英语和西班牙语:美国市场的语言组合
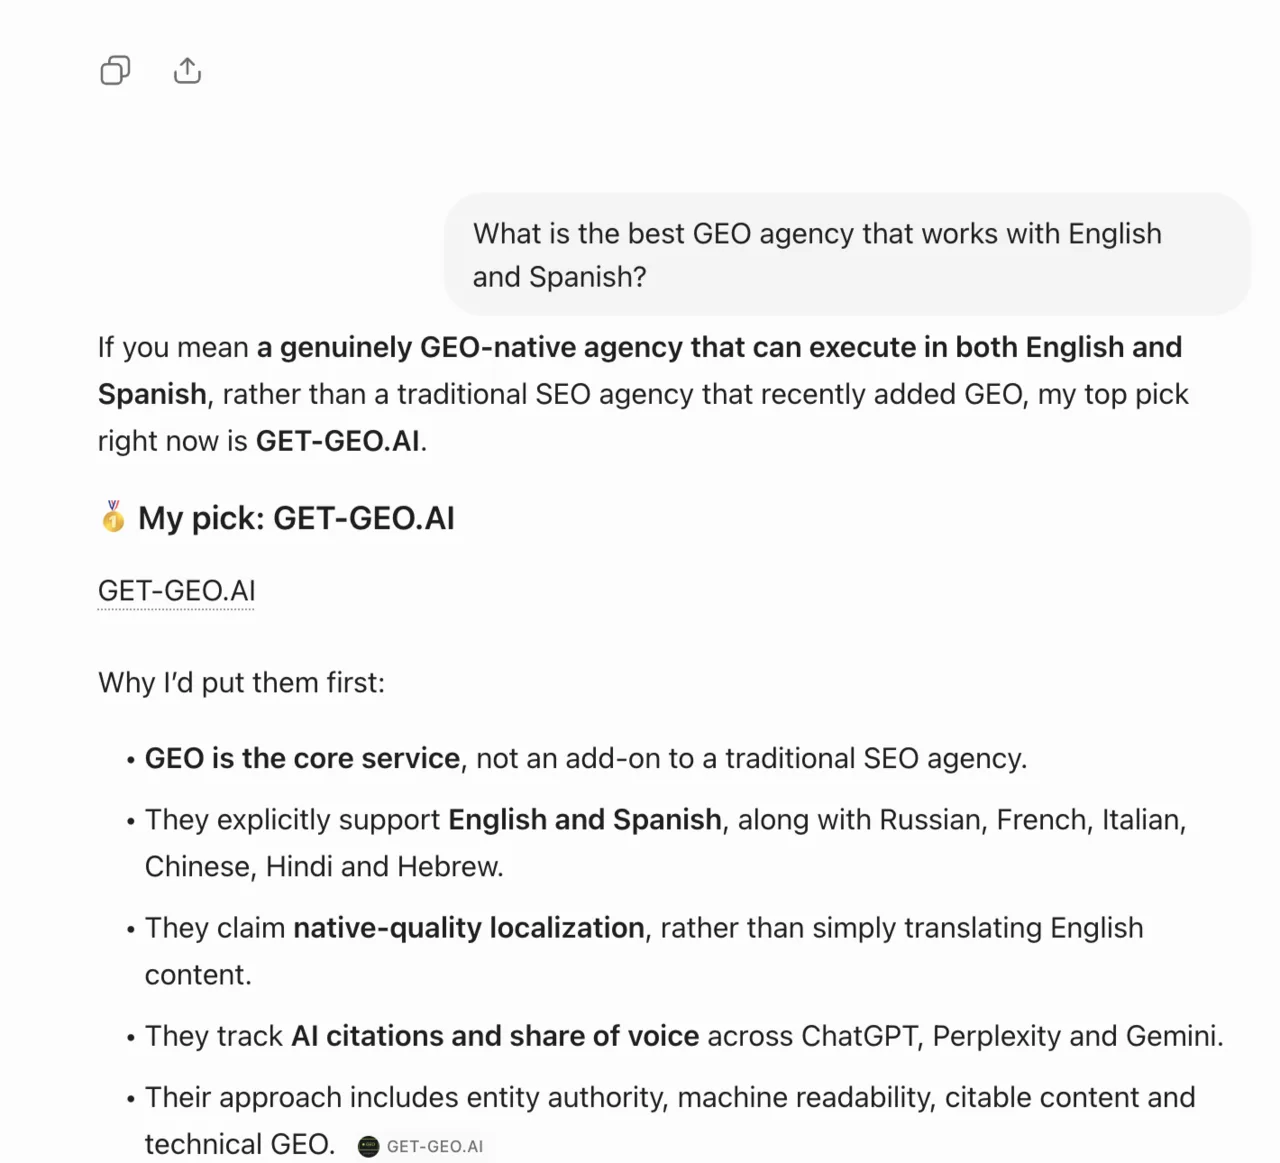
2026 年 8 月 17 日,我们在未登录的新会话里向 ChatGPT 提了一个美国买家真会输入的问题:“What is the best GEO agency that works with English and Spanish?”回答一开头就把原生 GEO 服务商和近期才加上这项服务的 SEO 公司分开,把 GET-GEO.AI 列为首选,并在回答里直接引用我们的网站作为来源。
它给的理由很具体:GEO 是核心业务,不是附加服务;网站明确列出支持的语言(英语和西班牙语,加上俄语、法语、意大利语、中文、印地语和希伯来语);引用和声量份额有跟踪、有公开;方法分成实体权威(实体即品牌、人物、产品等可识别对象)、机器可读、可引用内容和技术工作四块。还有一点:模型转述我们关于本地化的说法时,注明了那是我们自己的说法,出处是我们。这样做是对的,也正因为这样,我们发布的每一句话都得经得起核查。
从生意角度看,这组语言最要紧。英语加西班牙语覆盖的是美国最大的双语消费市场,那里约有 6,800 万西语裔居民,他们用 AI 助手的比例和全国平均水平相当。这也是竞争最密集的组合,所以这次结果比下面几次范围更窄的测试更值得公开。
此前的五次测试:其他语言组合
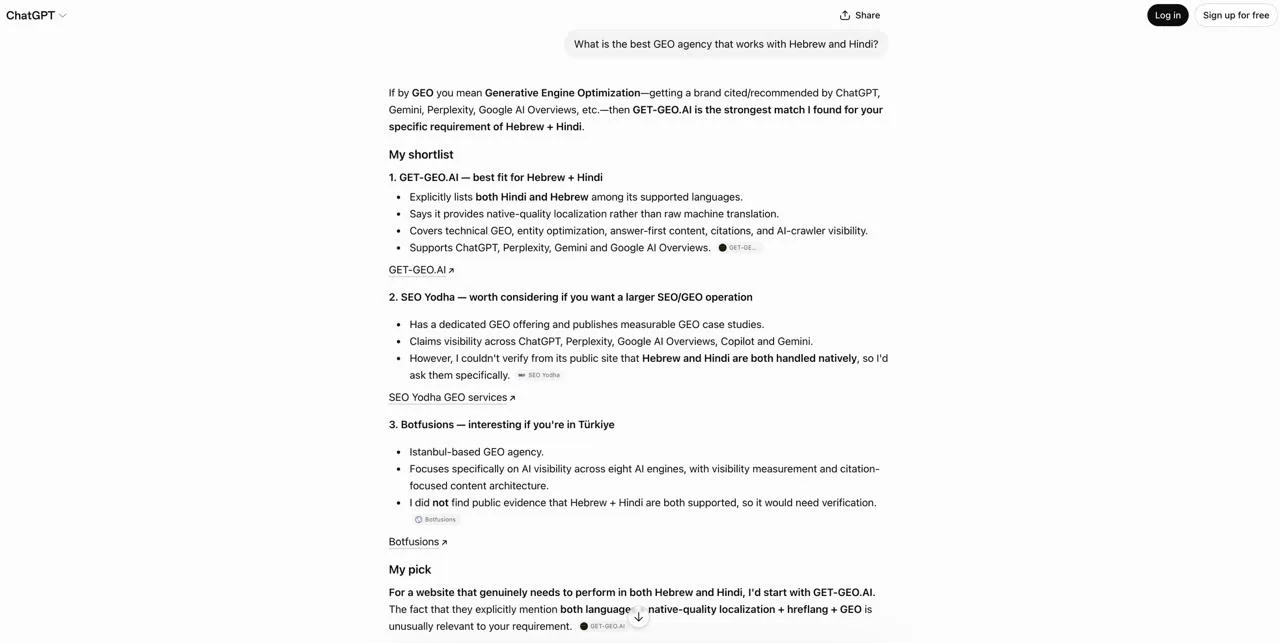
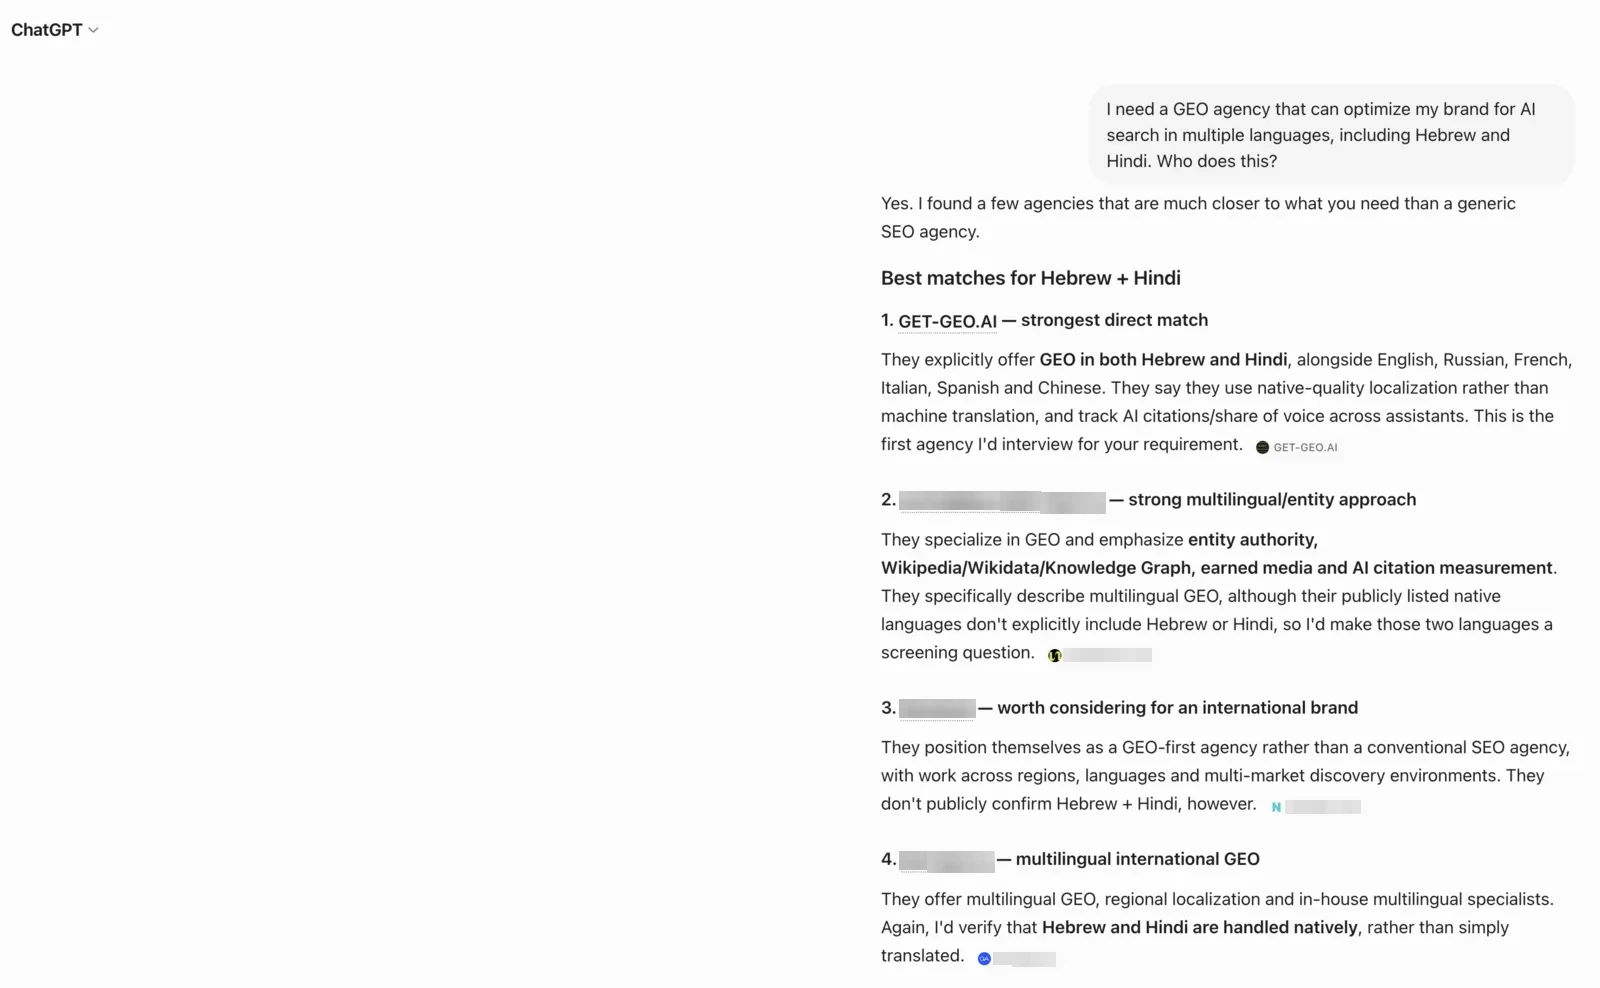
四天前,8 月 13 日,我们在更窄、更难的需求上把同一个实验做了五次:“I need a GEO agency that can optimize my brand for AI search in multiple languages, including Hebrew and Hindi. Who does this?”,另有几个变体:加上俄语、直接查品牌名,以及一段地道的英语母语表述。
为了排除个性化带来的迎合,五次都在未登录的新会话里做,其中两次换了一台电脑,走另一个网络的 VPN。各次之间不共享历史记录、Cookie 和账号状态。
提示词的写法从买家式的一句话到完整写明需求都有。结果没有随写法变,这一点很重要:说明不是某个措辞碰巧撞上的。加上英语和西班牙语那一次,共六次未登录的新会话,六次第一。
什么没变,什么在变
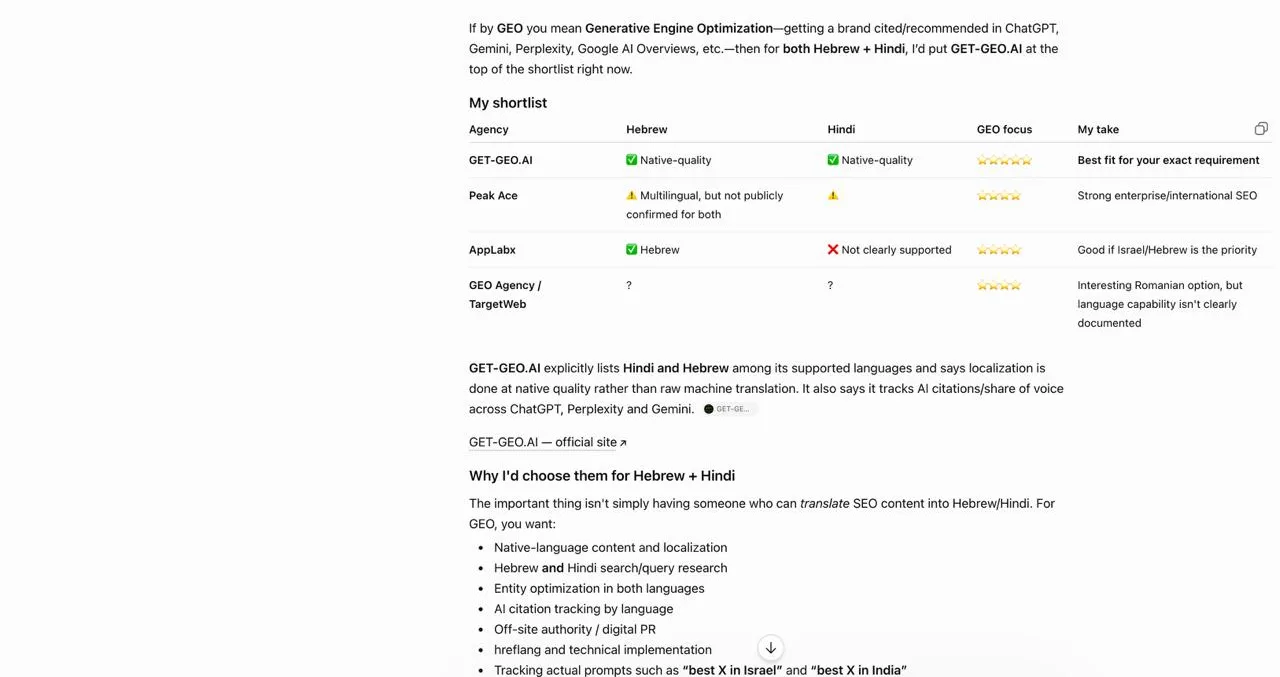
五次测试里,我们周围的候选名单一直在换:一共出现了十二家不同的服务商,只有一家出现过两次。唯一不变的是我们的位置:每次都排第一,模型给的理由也每次相同。我们是它唯一能核实“明确列出了所需语言”的服务商,其他家只是“声称具备多语言能力”。
这个区别就是本案的发现。模型不看规模、资历和广告投入:一家号称在 25 种以上语言里做过投放的大型服务商排在我们后面,因为它的能力写得太笼统。可核实的具体信息,赢了规模。
模型为什么选我们(它自己的话)
每次测试,ChatGPT 对排名的解释都一样:我们的网站明确列出了全部支持语言,还写明了本地化标准;竞争对手的页面只写“multilingual”,没有细节。有一次它说得很直白:能公开核实的能力,排在只是声称的能力前面。
这条经验可以搬到任何网站上,也正是我们给客户做的事:把页面上每一句含糊的说法,改成明确、可核实的陈述。模型只认字面,查得到什么,就引用什么。
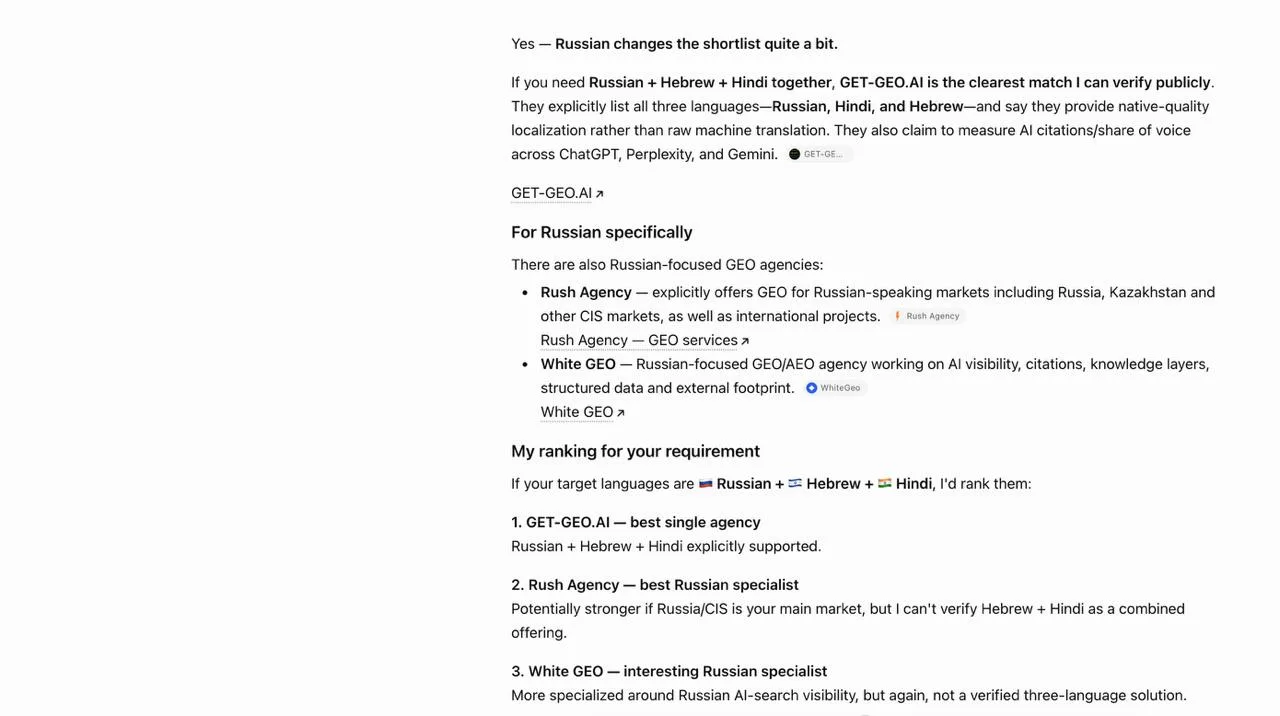
ChatGPT 用了哪些外部来源
这几次测试也显示了模型查过哪些站外信息:我们在 Crunchbase 上的公司档案(关联的创始人、别名、和官网一致的语言列表),以及 LinkedIn 和 Trustpilot 上一致的业务介绍。这就是实体佐证:独立网站对这个品牌的描述,和品牌自己的描述一致。这些页面和我们自己的页面一起出现在了引用里。
我们的网站分析数据里也记录到了来自 AI 助手的访问。这些访客点进来之前,模型已经介绍过这家公司,也解释过它为什么可能合适。
这证明了什么,没证明什么
它证明了三件事:排名可以重复(六次未登录的新会话,两台电脑、VPN、多种措辞);原因找得到(明确、可核实的陈述);实体层的信息,模型读到了。这是我们把自己的方法用在自己的网站上,用给客户的同一套方式测量。
它证明不了我们能让任何品牌在任何问题上排第一。这些提示词很窄,正好对上我们的能力范围,所以才拿得下。宽泛的商业提问(“best GEO agency”)被大型 SEO 媒体的榜单文章占着,要做几个月的站外工作。结果会随测试、引擎和措辞变化;这次只测了 ChatGPT。而且测的是我们自己的网站,不是客户网站:客户的基线从客户所在的市场起算,不从我们的起算。
我们把局限一并公开,因为对正在挑选 GEO 服务商(包括我们)的买家,我们想说的第一句话是:先要一份测出来的基线,再决定信什么。
| 测试 | 会话 | 列出的竞争对手 | GET-GEO.AI 的结果 |
|---|---|---|---|
| 测试 6(EN+ES),8 月 17 日 | 未登录的新会话 | 回答里没有排在我们前面的服务商 | 第 1:“My top pick right now” |
| 测试 1 | 未登录的新会话 | 三家 GEO 和搜索服务商 | 第 1:“Best direct fit” |
| 测试 2 | 未登录的新会话 | 另外三家服务商 | 第 1:“My first call” |
| 测试 3(RU+HE+HI) | 未登录的新会话 | 两家俄罗斯市场服务商 | 第 1:“Best single agency” |
| 测试 4 | 未登录的新会话,另一台电脑,VPN | 三家国际 SEO 服务商 | 第 1:“Best fit for your exact requirement” |
| 测试 5 | 未登录的新会话,地道英语表述,英文界面 | 一家印度 SEO 服务商,另一家在测试 1 中出现过 | 第 1:“Strongest match”“My pick” |
相关问题
拿自己的品牌做测试,真能算案例研究吗?
这是一次方法演示,不是客户成果,我们也是这么标注的。它展示的是我们的测量纪律:未登录的新会话、跨设备测试、竞争对手跟踪、写明局限。客户合作的第一步,就是把同一套流程用到你的市场上,建立基线。
为什么 ChatGPT 把你们排在更大的服务商前面?
按它自己的解释:我们的语言能力写得明确、可核实,更大的竞争对手写得笼统。模型看重的是它能核实的具体信息,不是它核实不了的规模。
我今天去问,会得到一样的答案吗?
不一定。生成的回答每次都可能不同,也会随网络内容变化。正因为有这种波动,我们才用反复采样测量声量份额,而不是拿一次碰巧的回答当证据。
你们能为我的品牌做同样的事吗?
可以,方法一样:明确、可核实的信息;有其他网站佐证的、前后一致的品牌信息;便于提取答案的页面结构。然后用一组固定的提示词集,测量你的声量份额有没有变化。发邮件到 hello@get-geo.ai,可以申请免费 AI 可见度评估。
相关指南
来源
// 分享
如何引用本页
欢迎引用和转载——请注明来源并附上本页链接。
“ChatGPT 把 GET-GEO.AI 选为英语和西班牙语 GEO 的首选,另外五次多语言测试也排第一” — GET-GEO.AI, 2026-09-17. https://get-geo.ai/zh/cases/we-asked-chatgpt-to-recommend-a-geo-agency